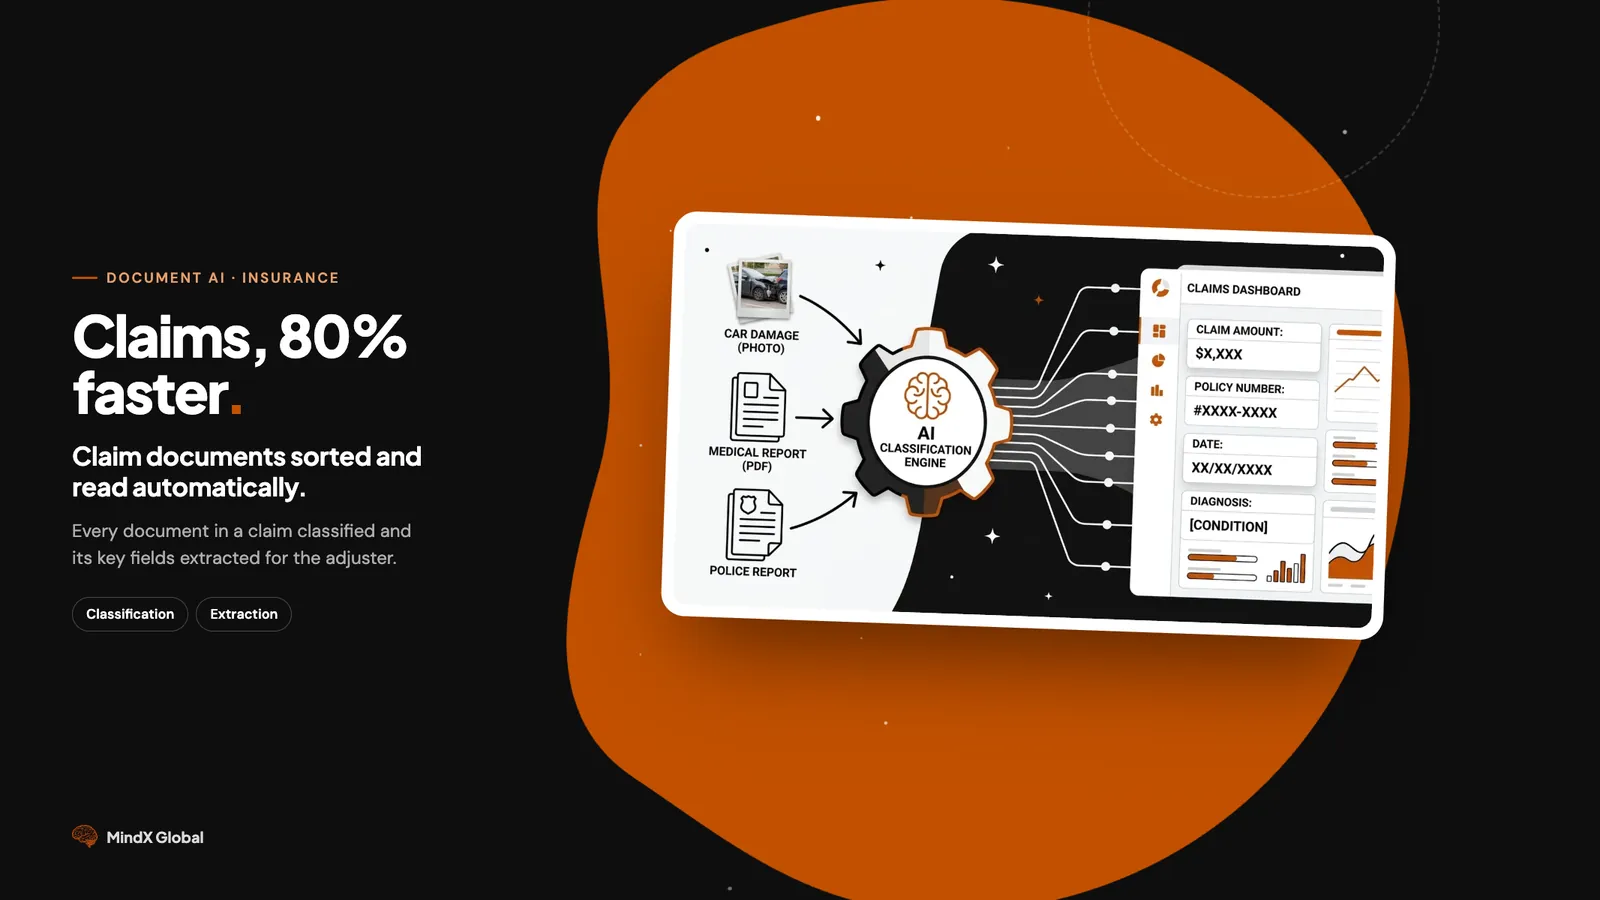
Das Problem: Schadensfälle sind ein Dokumenten-Albtraum
Ein Versicherungsschaden ist nicht ein Dokument — es ist ein ganzer Stapel. Ein einzelner Kfz-Schaden kann enthalten:
- Fotos des Fahrzeugschadens (aus mehreren Winkeln)
- Polizeibericht (gescanntes PDF)
- Arztunterlagen (bei Verletzungen)
- Reparaturkostenvoranschläge (von der Werkstatt)
- Führerschein (Identitätsprüfung)
- Versicherungskarte (Policendaten)
- Zeugenaussagen (handschriftlich oder getippt)
Ein Sachbearbeiter muss:
- Sortieren — alle Dokumente nach Typ
- Auslesen — die Schlüsselfelder aus jedem (Schadenshöhe, Policennummer, Datum, Diagnosecodes)
- Abgleichen — Angaben über die Dokumente hinweg
- Eingeben — alles ins Schadensystem
- Markieren — Unstimmigkeiten oder fehlende Dokumente
Das dauert 30–45 Minuten pro Fall. Bei 50 Fällen am Tag geht die gesamte Kapazität des Teams für Dateneingabe drauf statt für die eigentliche Schadenprüfung.
Was wäre, wenn sich die Dokumente selbst sortieren und auslesen würden?
Was wir entwickelt haben
Eine zweistufige KI-Pipeline, die zuerst jedes Dokument im Schadenpaket klassifiziert und es dann an spezialisierte Extraktionsmodelle weitergibt, die die relevanten Felder ziehen.
Stufe 1: Dokumentenklassifizierung
Jedes zu einem Schaden hochgeladene Dokument wird automatisch klassifiziert:
| Dokumenttyp | Klassifizierungsgenauigkeit |
|---|---|
| Schadenfotos | 98% |
| Polizeiberichte | 96% |
| Arztunterlagen | 94% |
| Kostenvoranschläge | 97% |
| Ausweisdokumente | 99% |
| Versicherungskarten | 98% |
| Korrespondenz | 91% |
Gesamtgenauigkeit der Klassifizierung: 94%
Falsch klassifizierte Dokumente landen in einer Warteschlange zur manuellen Prüfung, statt stillschweigend mit der falschen Vorlage verarbeitet zu werden.
Stufe 2: Feldextraktion
Jeder Dokumenttyp hat sein eigenes Extraktionsschema:
Aus Polizeiberichten:
- Datum, Uhrzeit, Ort des Vorfalls
- Beteiligte (Namen, Kennzeichen)
- Vermerke der Beamten und Verstoßcodes
- Berichtsnummer
Aus Arztunterlagen:
- Diagnosecodes (ICD-10)
- Behandlungsdaten und -einrichtungen
- Prozedurcodes (CPT)
- Abgerechneter Gesamtbetrag
Aus Kostenvoranschlägen:
- Fahrzeugdaten (Marke, Modell, Baujahr, VIN)
- Aufgeschlüsselte Schadensliste
- Arbeitsstunden und Teilekosten
- Gesamtsumme des Voranschlags
Aus Schadenfotos:
- Schwere des Schadens (leicht/mittel/schwer)
- Betroffene Bereiche (Frontstoßstange, Heckblech usw.)
- Plausibilitätsprüfung gegen den Kostenvoranschlag
Stufe 3: Zusammenführung des Falls
Alle extrahierten Daten fließen in einen einheitlichen Schadendatensatz:
- Policennummer und Versicherungsnehmer
- Zusammenfassung des Vorfalls
- Geforderter Gesamtbetrag
- Checkliste der Belege
- Hinweise auf fehlende Dokumente
- Markierte Unstimmigkeiten
Die harten Probleme
Dokumentenqualität
Schadensdokumente kommen in jeder erdenklichen Qualität. Handyfotos von Polizeiberichten. Gefaxte Arztunterlagen (ja, Fax gibt es im Gesundheitswesen noch). Screenshots von Textnachrichten. Wir haben für jeden Eingabetyp eine robuste Vorverarbeitung gebaut.
Abgleich zwischen Dokumenten
Der Betrag im Kostenvoranschlag sollte zu dem im System passen. Das Datum im Polizeibericht sollte zum Meldedatum passen. Wir haben Prüfregeln gebaut, die Abweichungen automatisch aufdecken.
Vertrauensbewertung
Nicht jede Extraktion ist gleich sicher. Eine sauber gedruckte Policennummer ist sehr sicher. Ein halb sichtbares Datum auf einem zerknitterten Polizeibericht ist unsicher. Wir zeigen die Vertrauenswerte an, damit Sachbearbeiter genau wissen, was sie nachprüfen müssen.
Ergebnisse
| Kennzahl | Manuell | Unser System |
|---|---|---|
| Zeit pro Fall | 30–45 Minuten | 5–8 Minuten |
| Dokumente sortieren | 5 Min. pro Fall | Sofort |
| Genauigkeit Feldextraktion | 92% (Mensch) | 94% |
| Erkennung fehlender Dokumente | Oft übersehen | 99% markiert |
| Verarbeitungskapazität | 50 Fälle/Tag/Team | 250+ Fälle/Tag |
Für einen mittelgroßen Versicherer mit 200 Fällen pro Tag:
- Vorher: 15 Sachbearbeiter, 60% der Zeit mit Dateneingabe
- Nachher: Dasselbe Team bearbeitet das 3-fache Volumen und konzentriert sich auf die Prüfung
- Wirkung: Durchschnittliche Bearbeitungszeit von 14 auf 5 Tage gesenkt
- Ersparnis: 400.000+ $ Personalkosten pro Jahr
Für wen das gedacht ist
- Versicherer, die Kfz-, Wohngebäude- oder Krankenschäden bearbeiten
- Schadenregulierer, die Fälle für mehrere Versicherer abwickeln
- Schadenbearbeitungs-Dienstleister, die pro Tag mehr Fälle schaffen müssen
- Kanzleien, die Fallakten und Beweisunterlagen sortieren
- Krankenversicherer, die Leistungsanträge und Vorabgenehmigungen bearbeiten