Das Problem: Ihre KI kann technische Dokumente nicht lesen
Sie haben GPT-4 Vision auf Ihren technischen Zeichnungen ausprobiert. Die Ergebnisse? Unbrauchbar.
Standard-KI-Ansätze scheitern bei spezialisierten Dokumenten, weil:
- Kein Fachwissen: Das Modell versteht keine Schaltschranklayouts, Stufenstrukturen oder Komponentenkonventionen
- Keine visuellen Anker: Es kann nicht unterscheiden, was wichtig ist und was Rauschen
- Inkonsistente Ausgaben: Jede Antwort hat ein anderes Format und bricht Ihre nachgelagerte Verarbeitung
- Fehlende Abschnitte: Kritische Daten werden komplett übersehen
Unser Kunde stand vor genau diesem Problem. Er musste Stufennummern, Breiten, Belüftungsstatus und Komponentenwerte aus elektrischen Schaltschrankzeichnungen extrahieren.
Erster Versuch mit Zero-Shot-Prompting: 18,2% Genauigkeit.
Das ist kein Tippfehler. Die KI lag in weniger als 1 von 5 Fällen richtig.
Was wäre, wenn Sie diese Genauigkeit verdreifachen könnten, ohne das Modell zu wechseln oder die Kosten zu erhöhen?
Was wir entwickelt haben: Few-Shot + Computer-Vision-Pipeline
Wir haben zwei Techniken kombiniert, die einzeln helfen, zusammen aber etwas Mächtiges schaffen:
| Technik | Was sie tut | Auswirkung |
|---|---|---|
| CV-Vorverarbeitung | Hebt Schlüsselbereiche hervor, bevor das LLM das Bild sieht | Fokussiert Aufmerksamkeit |
| Few-Shot-Beispiele | Zeigt dem Modell genau, wie Erfolg aussieht | Lehrt Muster |
| Strukturierte Ausgabe | Erzwingt JSON-Schema mit Pydantic | Garantiert gültige Daten |
Die Ergebnisse
| Kennzahl | Zero-Shot | Few-Shot (4 Beispiele) | Verbesserung |
|---|---|---|---|
| Exact-Match-Rate | 18,2% | 54,5% | +36,3% |
| Feldgenauigkeit | 78,7% | 92,6% | +13,9% |
| Stufenanzahl-Genauigkeit | 72,7% | 100,0% | +27,3% |
Die Stufenanzahl stieg von 72,7% auf 100%. Das Zero-Shot-Modell verstand die Dokumentstruktur grundlegend falsch. Mit Beispielen lag es jedes einzelne Mal richtig.
Schritt 1: Computer-Vision-Vorverarbeitung
Bevor das LLM Ihr Dokument überhaupt sieht, bereiten Sie es visuell vor.
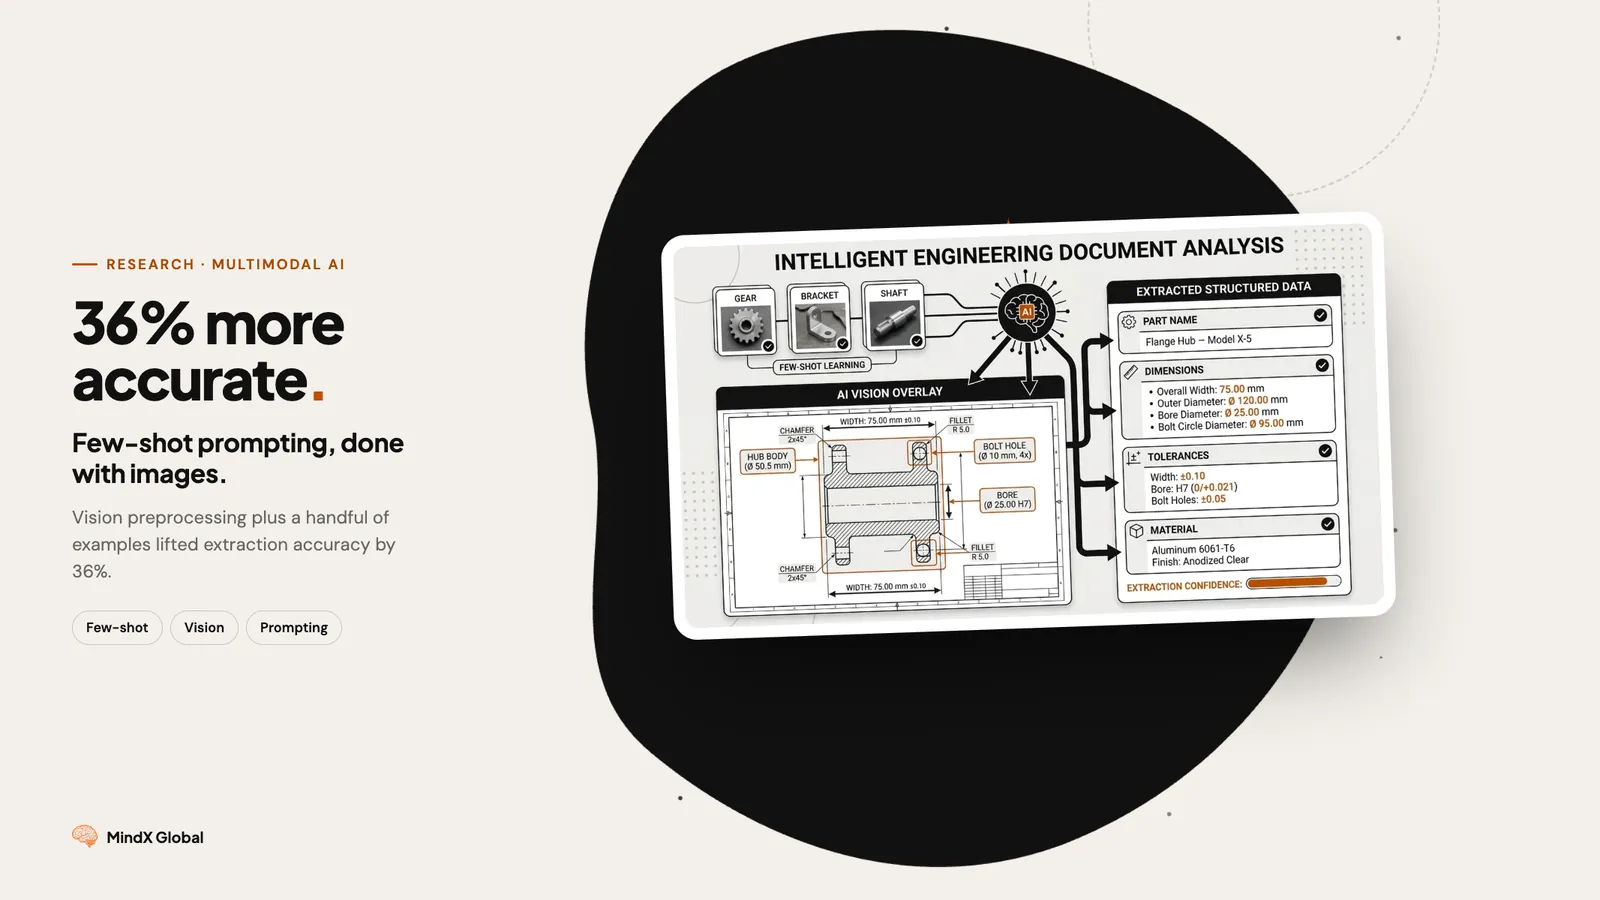
Wir haben ein leichtgewichtiges Erkennungsmodell (Roboflow) trainiert, um Schlüsselkomponenten zu identifizieren:
- MCMP-Platten: Gelbe Überlagerung + grüner Rahmen
- Messeinheiten: Blaue Rahmenumrandung
Das LLM erhält ein "Spickzettel"-Bild. Statt die gesamte komplexe Zeichnung zu scannen, weiß es genau, wo es schauen muss.
Stellen Sie sich vor, Sie markieren ein Lehrbuch vor einer Prüfung. Der Inhalt ist derselbe, aber die wichtigen Teile sind hervorgehoben.
Schritt 2: Few-Shot-Beispiele, die wirklich funktionieren
Der Unterschied zwischen gutem und großartigem Few-Shot-Prompting liegt in der Beispielauswahl.
Schlechte Beispiele
- Alle ähnlich komplex
- Gleicher Dokumenttyp
- Keine Randfälle
Gute Beispiele (Was wir verwendet haben)
- Beispiel 1: Einfaches Layout, minimale Komponenten
- Beispiel 2: Starke Belüftung, komplexe Stufenstruktur
- Beispiel 3: Gemischte Komponenten, ungewöhnliche Breiten
- Beispiel 4: Randfall mit fehlenden Daten
Schlüsselerkenntnis: 4 diverse Beispiele schlagen 20 ähnliche. Qualität und Abdeckung zählen mehr als Quantität.
Schritt 3: Struktur mit Pydantic erzwingen
Selbst mit großartigen Beispielen können LLMs fehlerhaftes JSON ausgeben. Wir verwenden Pydantic, um gültige Ausgaben zu garantieren — keine JSON-Parsing-Fehler mehr, keine fehlenden Felder, keine Typ-Diskrepanzen.
Was Sie heute anwenden können
- Beginnen Sie nicht mit dem LLM. Verwenden Sie CV zur Vorverarbeitung und Hervorhebung wichtiger Bereiche.
- Erstellen Sie einen diversen Beispielsatz. Decken Sie Randfälle ab, nicht nur Standardszenarien. 4-6 hochwertige Beispiele schlagen 20 mittelmäßige.
- Erzwingen Sie Struktur. Verwenden Sie Pydantic, Zod oder JSON Schema. Vertrauen Sie niemals freiformatiger LLM-Ausgabe in der Produktion.
- Messen Sie richtig. Verfolgen Sie Exact-Match-Rate UND Feldgenauigkeit. Sie erzählen verschiedene Geschichten.
| Anwendungsfall | Erwartete Verbesserung |
|---|---|
| Technische Zeichnungen | 30-40% Genauigkeitssteigerung |
| Medizinische Formulare | 20-35% Genauigkeitssteigerung |
| Finanzdokumente | 25-40% Genauigkeitssteigerung |
| Handschriftliche Formulare | 15-30% Genauigkeitssteigerung |
Ergebniszusammenfassung
| Vorher | Nachher | Auswirkung |
|---|---|---|
| 18,2% Exact Match | 54,5% Exact Match | 3x Verbesserung |
| Inkonsistentes JSON | Garantiertes Schema | Null Parsing-Fehler |
| Manuelle Prüfung nötig | Automatisierte Pipeline | Stunden täglich gespart |
| Prototyp-Qualität | Produktionsreif | Beim Kunden implementiert |