Le problème : les sinistres sont un cauchemar documentaire
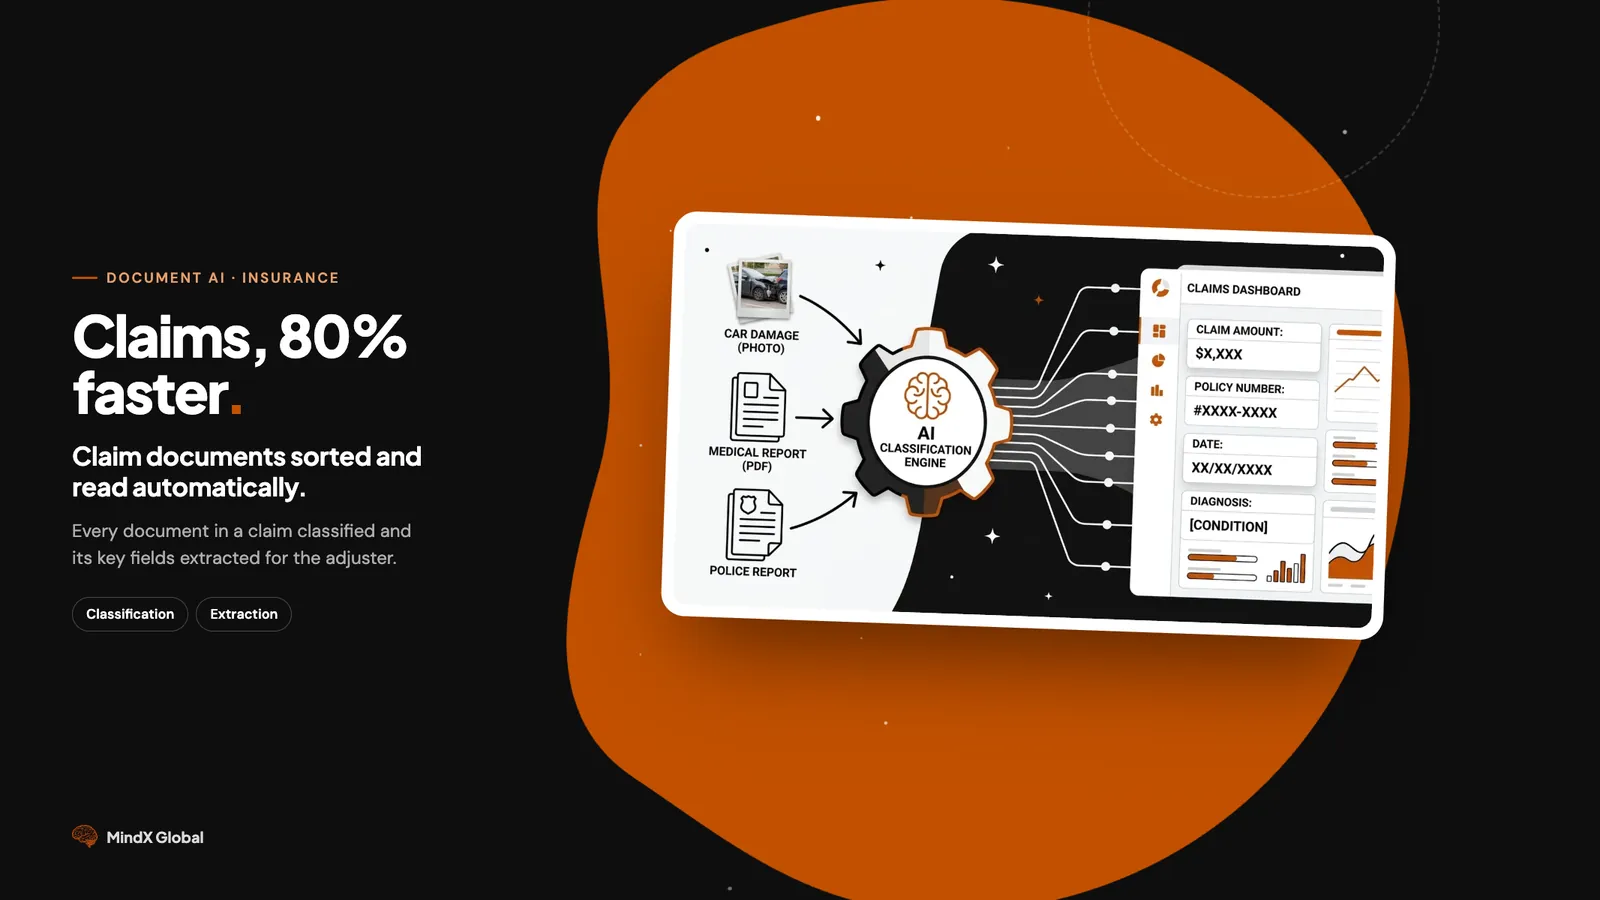
Un sinistre d'assurance, ce n'est pas un document — c'est une pile. Un seul sinistre auto peut comprendre :
- Des photos des dégâts du véhicule (sous plusieurs angles)
- Un procès-verbal de police (PDF scanné)
- Des documents médicaux (en cas de blessures)
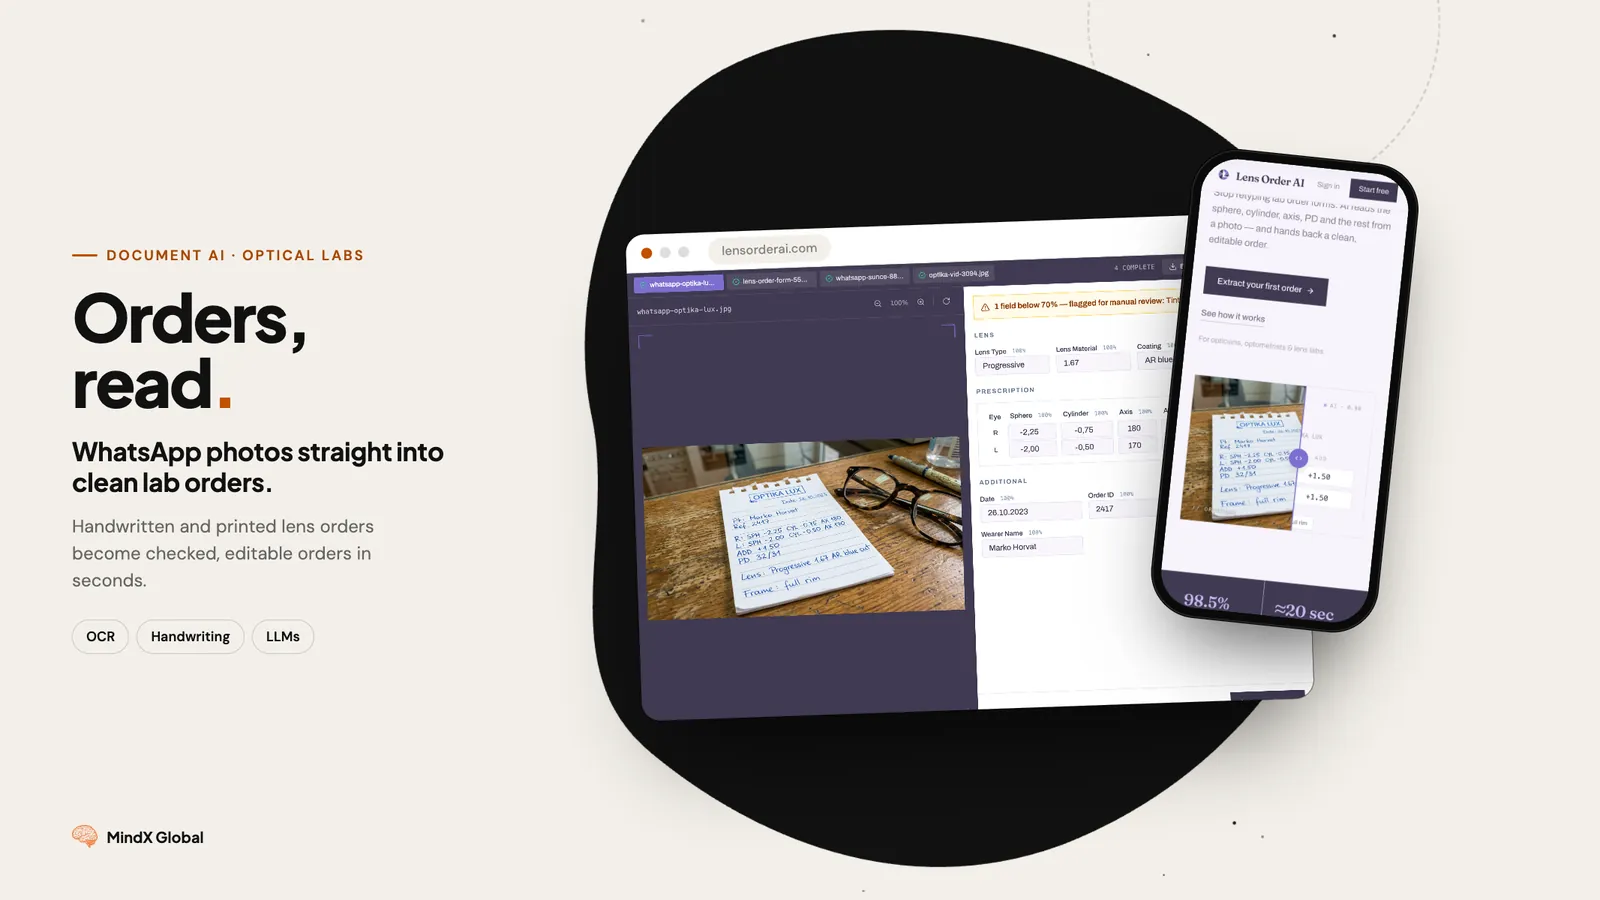
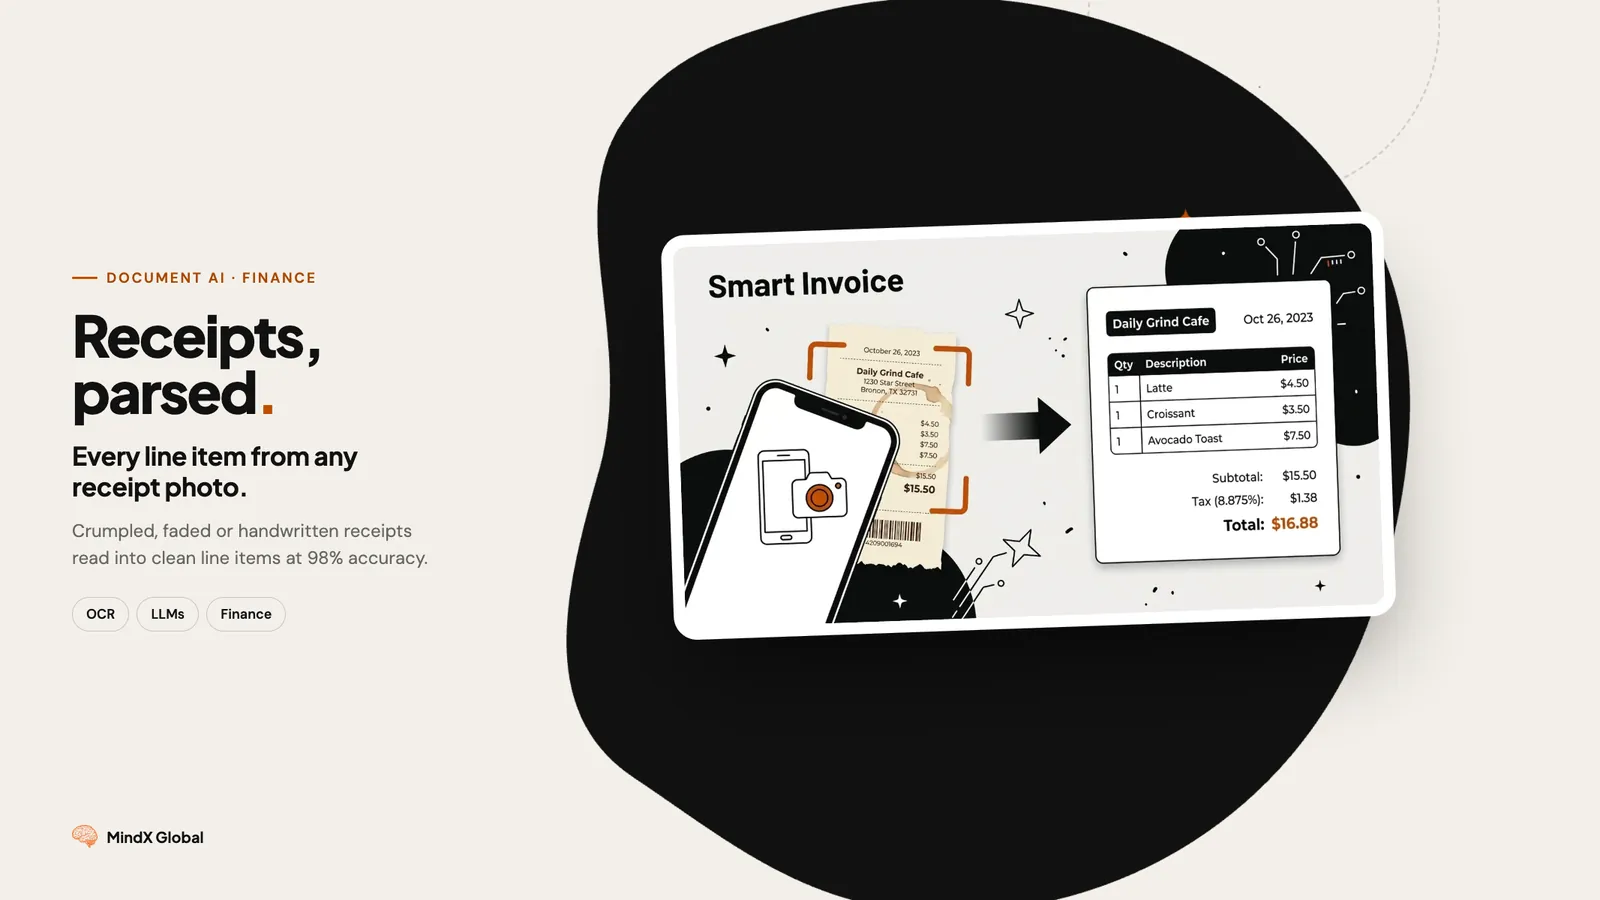
- Des devis de réparation (du carrossier)
- Le permis de conduire (vérification d'identité)
- La carte d'assurance (détails du contrat)
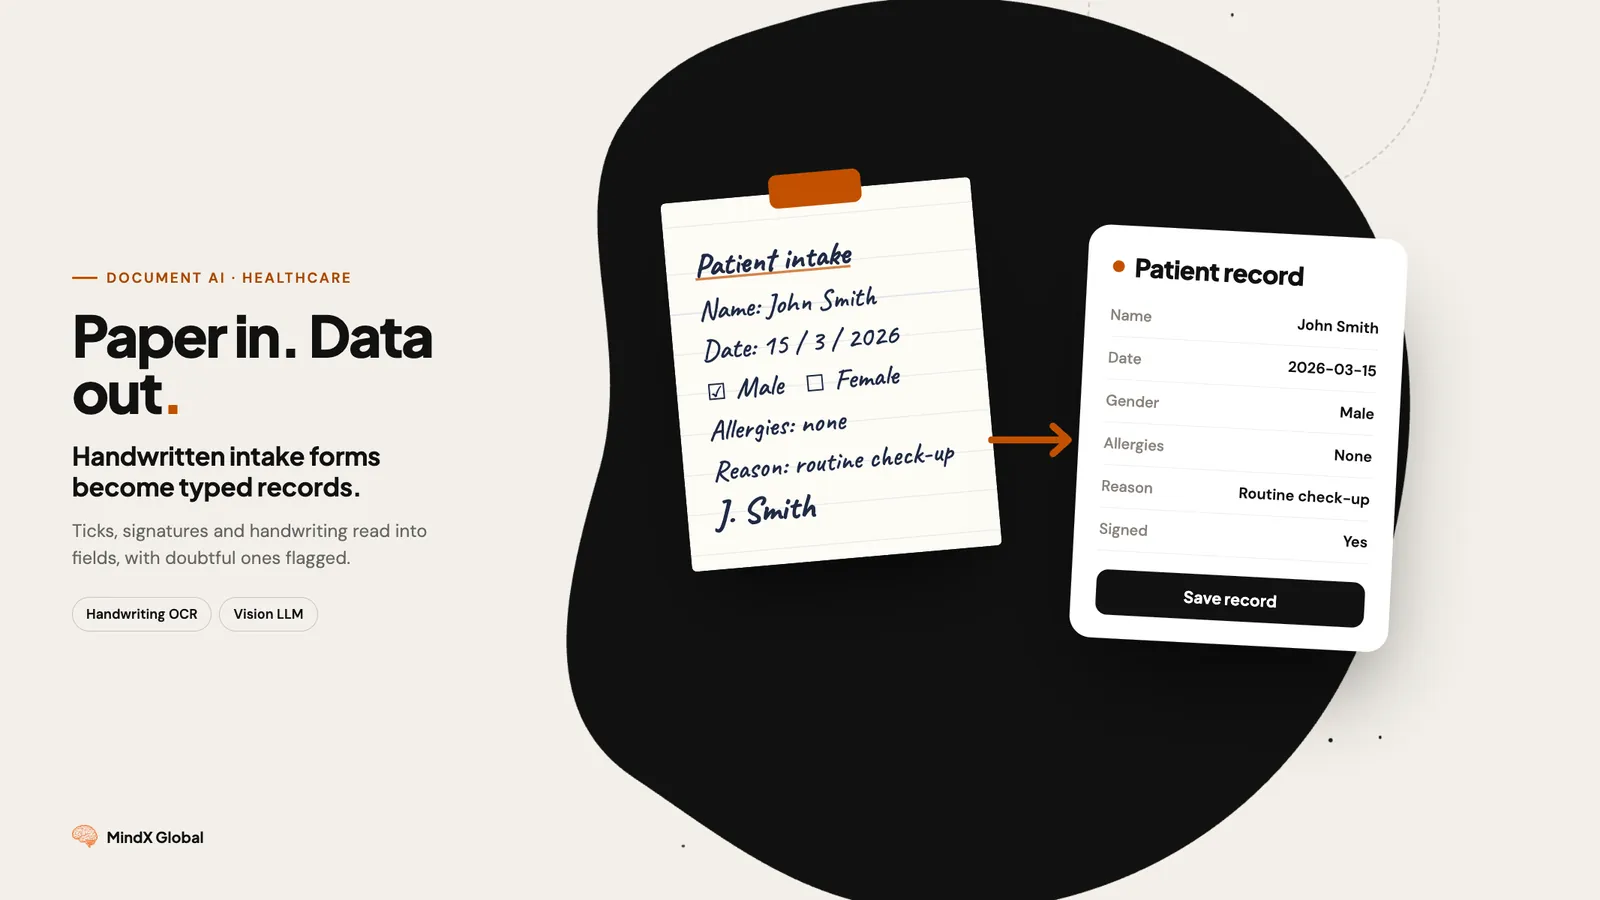
- Des témoignages (manuscrits ou dactylographiés)
Un gestionnaire de sinistres doit :
- Trier tous ces documents par type
- Extraire les champs clés de chacun (montant réclamé, numéro de contrat, date, codes de diagnostic)
- Recouper les informations entre les documents
- Saisir le tout dans le système de gestion des sinistres
- Signaler les incohérences ou les documents manquants
Cela prend 30 à 45 minutes par sinistre. Avec 50 sinistres par jour, toute la capacité de l'équipe part dans la saisie au lieu de l'évaluation proprement dite.
Et si les documents pouvaient se trier et s'extraire tout seuls ?
Ce que nous avons construit
Un pipeline d'IA en deux étapes qui classe d'abord chaque document du dossier, puis l'envoie à des modèles d'extraction spécialisés qui en tirent les champs pertinents.
Étape 1 : classification des documents
Chaque document téléversé dans un dossier est classé automatiquement :
| Type de document | Précision de classification |
|---|---|
| Photos de dégâts | 98 % |
| Procès-verbaux de police | 96 % |
| Documents médicaux | 94 % |
| Devis de réparation | 97 % |
| Pièces d'identité | 99 % |
| Cartes d'assurance | 98 % |
| Correspondance | 91 % |
Précision globale de classification : 94 %
Les documents mal classés sont dirigés vers une file de vérification humaine plutôt que traités en silence avec le mauvais modèle d'extraction.
Étape 2 : extraction des champs
Chaque type de document a son propre schéma d'extraction :
Des procès-verbaux de police :
- Date, heure, lieu de l'incident
- Parties impliquées (noms, plaques d'immatriculation)
- Notes de l'agent et codes d'infraction
- Numéro du procès-verbal
Des documents médicaux :
- Codes de diagnostic (CIM-10)
- Dates de traitement et praticiens
- Codes d'actes (CPT)
- Montant total facturé
Des devis de réparation :
- Détails du véhicule (marque, modèle, année, VIN)
- Liste détaillée des dégâts
- Heures de main-d'œuvre et coût des pièces
- Montant total du devis
Des photos de dégâts :
- Gravité des dégâts (légers/modérés/graves)
- Zones touchées (pare-chocs avant, panneau arrière, etc.)
- Contrôle de cohérence avec le devis de réparation
Étape 3 : assemblage du dossier
Toutes les données extraites sont fusionnées dans un dossier de sinistre unifié :
- Numéro de contrat et informations sur l'assuré
- Résumé de l'incident
- Montant total réclamé
- Liste de contrôle des pièces justificatives
- Alertes de documents manquants
- Signalements d'incohérences
Les problèmes difficiles
La qualité des documents
Les documents de sinistre arrivent dans tous les états imaginables. Photos de procès-verbaux prises au téléphone. Documents médicaux faxés (oui, le fax existe encore dans la santé). Captures d'écran de SMS. Nous avons construit un prétraitement robuste pour chaque type d'entrée.
La validation croisée
Le montant du devis de réparation doit correspondre à celui du système. La date du procès-verbal doit correspondre à la date de déclaration. Nous avons construit des règles de validation qui détectent automatiquement les écarts.
Le score de confiance
Toutes les extractions ne se valent pas. Un numéro de contrat bien imprimé est très fiable. Une date à moitié visible sur un procès-verbal froissé l'est peu. Nous affichons les scores de confiance pour que les gestionnaires sachent exactement quoi revérifier.
Résultats
| Indicateur | Processus manuel | Notre système |
|---|---|---|
| Temps par sinistre | 30 à 45 minutes | 5 à 8 minutes |
| Tri des documents | 5 min par sinistre | Immédiat |
| Précision de l'extraction | 92 % (humain) | 94 % |
| Détection des documents manquants | Souvent oubliée | 99 % signalés |
| Capacité de traitement | 50 sinistres/jour/équipe | 250+ sinistres/jour |
Pour un assureur de taille moyenne qui traite 200 sinistres par jour :
- Avant : 15 gestionnaires passant 60 % de leur temps à la saisie
- Après : La même équipe traite 3 fois plus de volume et se concentre sur l'évaluation
- Impact : Délai moyen de règlement ramené de 14 à 5 jours
- Économie : 400 000 $+ de coûts de main-d'œuvre par an
À qui cela s'adresse
- Les assureurs qui gèrent des sinistres auto, habitation ou santé
- Les gestionnaires délégués qui traitent des sinistres pour plusieurs assureurs
- Les sociétés de gestion de sinistres qui doivent traiter plus de dossiers par jour
- Les cabinets d'avocats qui trient dossiers et pièces
- Les assureurs santé qui traitent remboursements et accords préalables