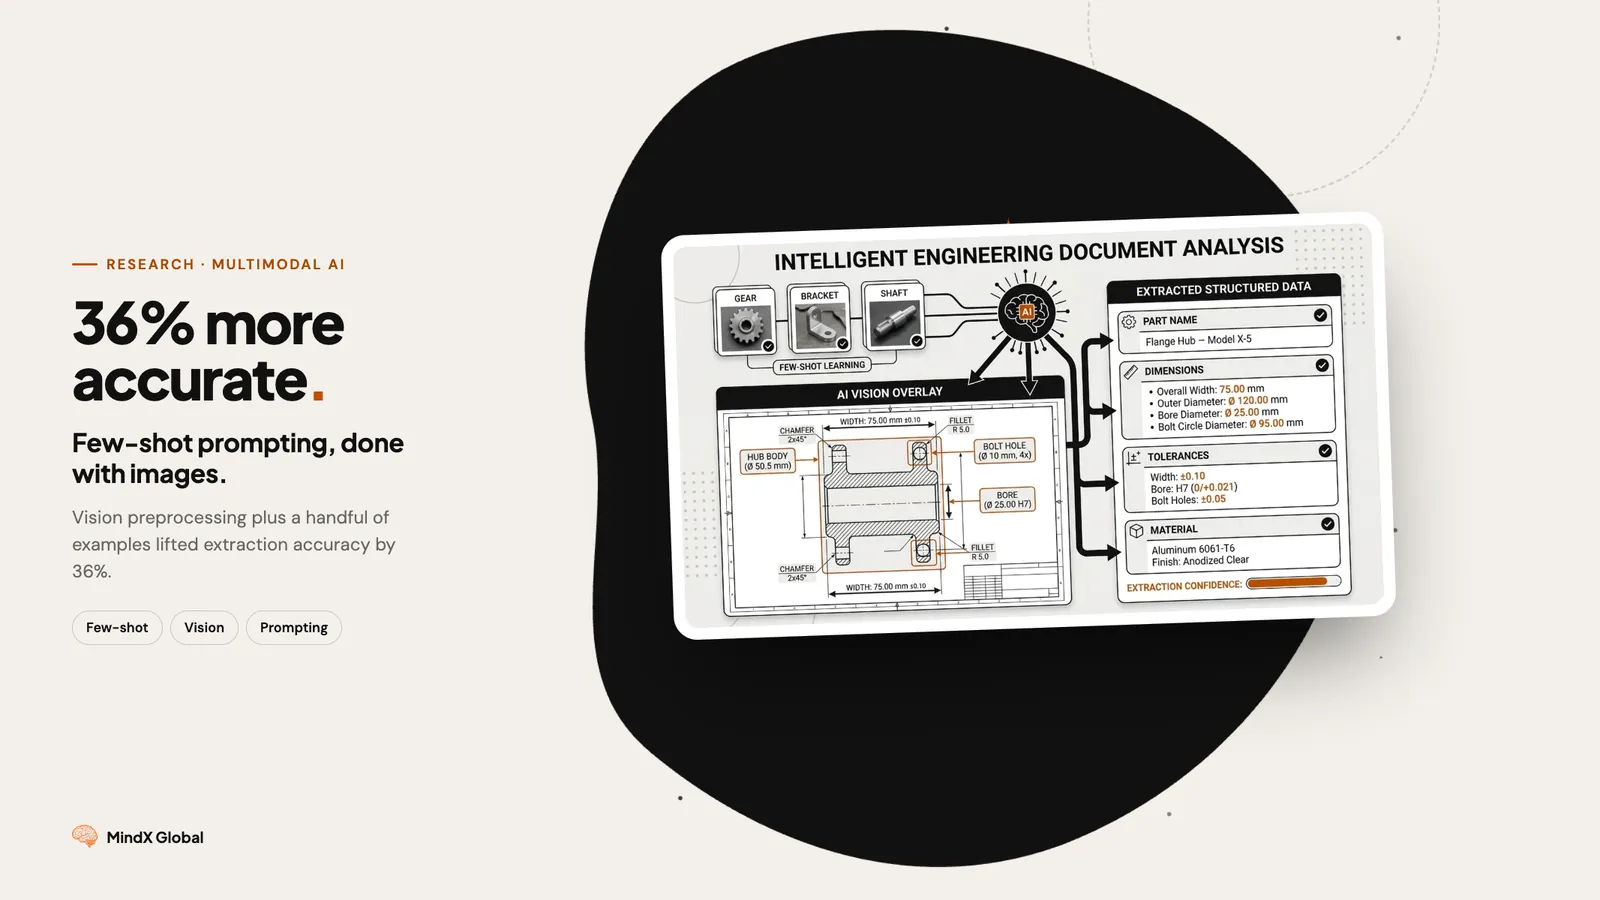
Le problème : votre IA ne peut pas lire les documents techniques
Vous avez essayé GPT-4 Vision sur vos dessins techniques. Les résultats ? Inutilisables.
Les approches IA standard échouent sur les documents spécialisés car :
- Pas de connaissance du domaine : Le modèle ne comprend pas les configurations de tableaux, les structures en niveaux ou les conventions de composants
- Pas d'ancrage visuel : Il ne peut pas distinguer ce qui est important de ce qui est du bruit
- Sorties incohérentes : Chaque réponse a un format différent, cassant votre traitement en aval
- Sections manquées : Des données critiques sont complètement ignorées
Notre client faisait face exactement à ce problème. Il devait extraire les numéros de niveaux, les largeurs, l'état de ventilation et les valeurs de composants à partir de dessins de tableaux électriques.
Première tentative avec prompting zero-shot : 18,2% de précision.
Ce n'est pas une faute de frappe. L'IA n'avait raison que moins d'1 fois sur 5.
Et si vous pouviez tripler cette précision sans changer de modèle ni augmenter les coûts ?
Ce que nous avons construit : pipeline few-shot + vision par ordinateur
Nous avons combiné deux techniques qui aident individuellement, mais ensemble créent quelque chose de puissant :
| Technique | Ce qu'elle fait | Impact |
|---|---|---|
| Prétraitement CV | Met en surbrillance les zones clés avant que le LLM ne voie l'image | Concentre l'attention |
| Exemples few-shot | Montre au modèle exactement à quoi ressemble le succès | Enseigne les patterns |
| Sortie structurée | Impose un schéma JSON avec Pydantic | Garantit des données valides |
Les résultats
| Métrique | Zero-Shot | Few-Shot (4 exemples) | Amélioration |
|---|---|---|---|
| Taux de correspondance exacte | 18,2% | 54,5% | +36,3% |
| Précision au niveau des champs | 78,7% | 92,6% | +13,9% |
| Précision du comptage de niveaux | 72,7% | 100,0% | +27,3% |
Le comptage de niveaux est passé de 72,7% à 100%. Le modèle zero-shot comprenait fondamentalement mal la structure du document. Avec des exemples, il a eu raison à chaque fois.
Étape 1 : Prétraitement par vision par ordinateur
Avant que le LLM ne voie votre document, préparez-le visuellement.
Nous avons entraîné un modèle de détection léger (Roboflow) pour identifier les composants clés :
- Plaques MCMP : Superposition jaune + bordure verte
- Unités de mesure : Contour bordure bleue
Le LLM reçoit une image « aide-mémoire ». Au lieu de scanner tout le dessin complexe, il sait exactement où se concentrer.
C'est comme surligner un manuel avant un examen. Le contenu est le même, mais les parties importantes sont marquées.
Étape 2 : Des exemples few-shot qui fonctionnent vraiment
La différence entre un bon et un excellent prompting few-shot réside dans la sélection des exemples.
Mauvais exemples
- Tous de complexité similaire
- Même type de document
- Pas de cas limites
Bons exemples (ce que nous avons utilisé)
- Exemple 1 : Disposition simple, composants minimaux
- Exemple 2 : Ventilation importante, structure de niveaux complexe
- Exemple 3 : Composants mixtes, largeurs inhabituelles
- Exemple 4 : Cas limite avec données manquantes
Point clé : 4 exemples diversifiés battent 20 exemples similaires. La qualité et la couverture comptent plus que la quantité.
Étape 3 : Imposer la structure avec Pydantic
Même avec d'excellents exemples, les LLM peuvent produire du JSON malformé. Nous utilisons Pydantic pour garantir des sorties valides — plus d'erreurs de parsing JSON, de champs manquants ou de discordances de types.
Ce que vous pouvez appliquer dès aujourd'hui
- Ne commencez pas par le LLM. Utilisez la CV pour prétraiter et mettre en surbrillance les régions clés d'abord.
- Constituez un jeu d'exemples diversifié. Couvrez les cas limites, pas seulement les cas nominaux. 4-6 exemples de haute qualité battent 20 médiocres.
- Imposez la structure. Utilisez Pydantic, Zod ou JSON Schema. Ne faites jamais confiance à une sortie LLM en texte libre en production.
- Mesurez correctement. Suivez le taux de correspondance exacte ET la précision au niveau des champs. Ils racontent des histoires différentes.
| Cas d'usage | Amélioration attendue |
|---|---|
| Dessins techniques | 30-40% de précision en plus |
| Formulaires médicaux | 20-35% de précision en plus |
| Documents financiers | 25-40% de précision en plus |
| Formulaires manuscrits | 15-30% de précision en plus |
Résumé des résultats
| Avant | Après | Impact |
|---|---|---|
| 18,2% de correspondance exacte | 54,5% de correspondance exacte | Amélioration 3x |
| JSON incohérent | Schéma garanti | Zéro erreur de parsing |
| Revue manuelle requise | Pipeline automatisé | Des heures économisées quotidiennement |
| Qualité prototype | Prêt pour la production | Déployé chez le client |