O problema: sinistros são um pesadelo de documentos
Um sinistro não é um documento — é uma pilha deles. Um único sinistro de automóvel pode incluir:
- Fotos dos danos do veículo (de vários ângulos)
- Boletim de ocorrência (PDF digitalizado)
- Prontuários médicos (se houver feridos)
- Orçamentos de reparo (da oficina)
- Carteira de motorista (verificação de identidade)
- Cartão do seguro (dados da apólice)
- Depoimentos de testemunhas (à mão ou digitados)
Um regulador de sinistros precisa:
- Classificar todos esses documentos por tipo
- Extrair os campos-chave de cada um (valor reclamado, número da apólice, data, códigos de diagnóstico)
- Cruzar as informações entre documentos
- Lançar tudo no sistema de gestão de sinistros
- Sinalizar inconsistências ou documentos faltantes
Isso leva de 30 a 45 minutos por sinistro. Com 50 sinistros por dia, toda a capacidade da equipe vai para digitação em vez de para a análise do sinistro em si.
E se os documentos pudessem se classificar e se extrair sozinhos?
O que construímos
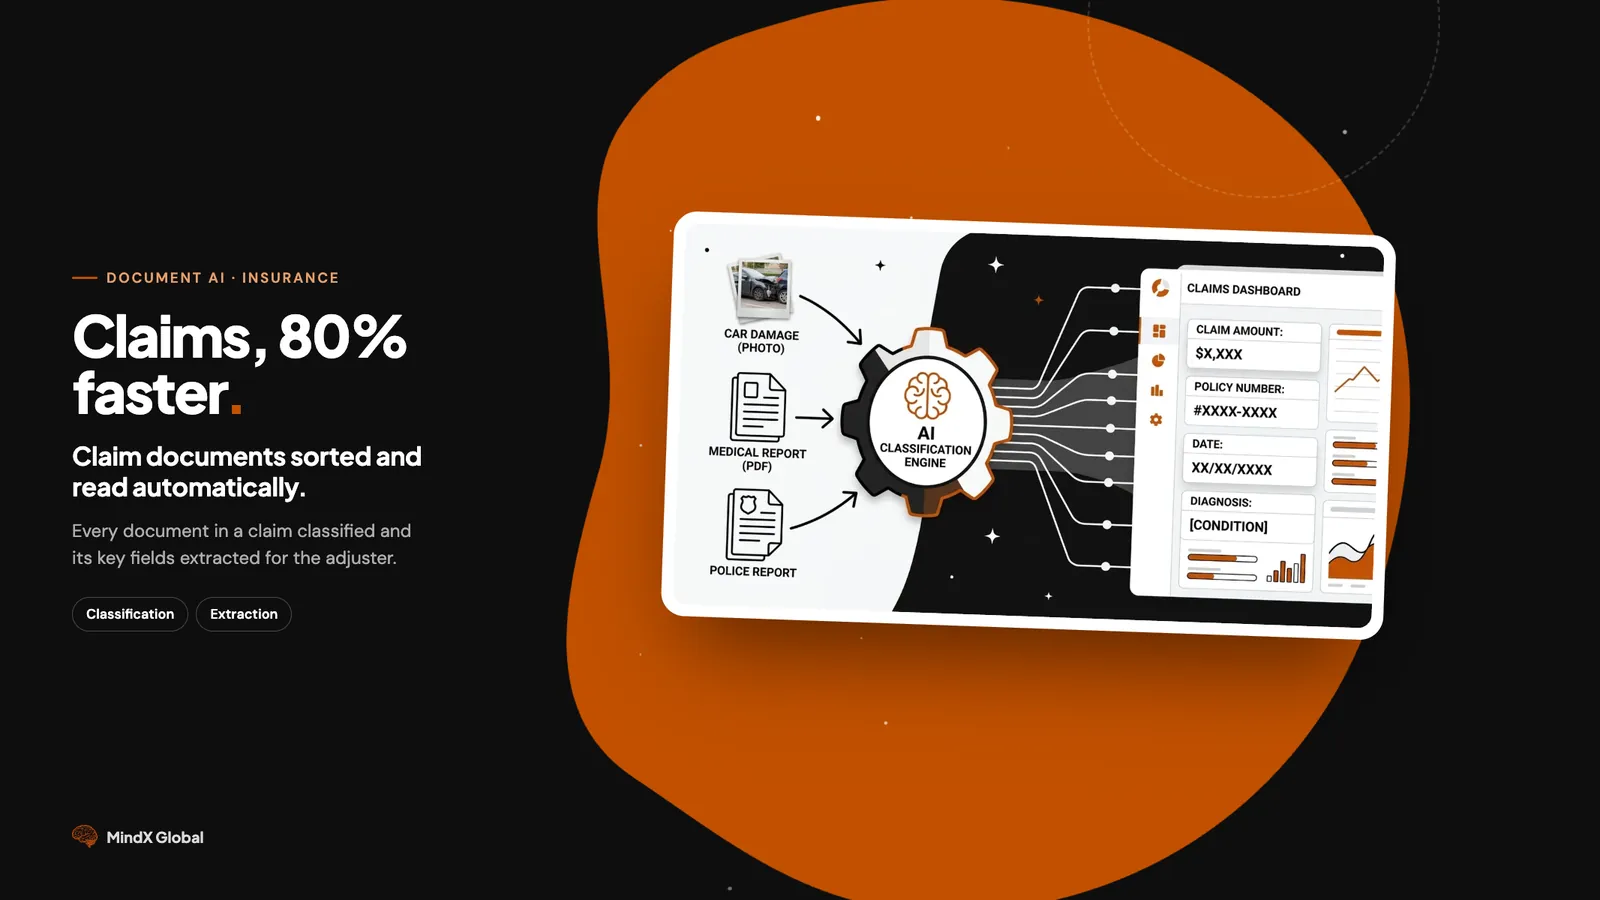
Um pipeline de IA em duas etapas que primeiro classifica cada documento do processo e depois o encaminha a modelos de extração especializados que puxam os campos relevantes.
Etapa 1: classificação dos documentos
Cada documento enviado a um sinistro é classificado automaticamente:
| Tipo de documento | Precisão da classificação |
|---|---|
| Fotos de danos | 98% |
| Boletins de ocorrência | 96% |
| Prontuários médicos | 94% |
| Orçamentos de reparo | 97% |
| Documentos de identidade | 99% |
| Cartões do seguro | 98% |
| Correspondência | 91% |
Precisão geral da classificação: 94%
Documentos classificados errado vão para uma fila de revisão humana em vez de serem processados em silêncio com o modelo de extração errado.
Etapa 2: extração dos campos
Cada tipo de documento tem seu próprio esquema de extração:
Dos boletins de ocorrência:
- Data, hora e local da ocorrência
- Partes envolvidas (nomes, placas)
- Anotações do agente e códigos de infração
- Número do boletim
Dos prontuários médicos:
- Códigos de diagnóstico (CID-10)
- Datas de atendimento e prestadores
- Códigos de procedimento (CPT)
- Valor total faturado
Dos orçamentos de reparo:
- Dados do veículo (marca, modelo, ano, chassi/VIN)
- Lista detalhada dos danos
- Horas de mão de obra e custo das peças
- Valor total do orçamento
Das fotos de danos:
- Gravidade do dano (leve/moderado/grave)
- Áreas afetadas (para-choque dianteiro, painel traseiro etc.)
- Verificação de consistência com o orçamento
Etapa 3: montagem do sinistro
Todos os dados extraídos se fundem num registro único do sinistro:
- Número da apólice e dados do segurado
- Resumo da ocorrência
- Valor total reclamado
- Checklist das evidências
- Alertas de documentos faltantes
- Sinalizações de inconsistência
Os problemas difíceis
Qualidade dos documentos
Documentos de sinistro chegam em toda qualidade imaginável. Fotos de boletins tiradas pelo celular. Prontuários por fax (sim, o fax ainda existe na saúde). Capturas de tela de mensagens. Construímos um pré-processamento robusto para cada tipo de entrada.
Validação cruzada
O valor do orçamento de reparo deve bater com o do sistema. A data do boletim deve bater com a data da abertura do sinistro. Criamos regras de validação que pegam divergências automaticamente.
Pontuação de confiança
Nem toda extração tem a mesma confiança. Um número de apólice bem impresso tem alta confiança. Uma data meio visível num boletim amassado tem baixa confiança. Mostramos as pontuações de confiança para que os reguladores saibam exatamente o que conferir.
Resultados
| Métrica | Processo manual | Nosso sistema |
|---|---|---|
| Tempo por sinistro | 30-45 minutos | 5-8 minutos |
| Classificação dos documentos | 5 min por sinistro | Instantânea |
| Precisão da extração | 92% (humano) | 94% |
| Detecção de documentos faltantes | Muitas vezes passa | 99% sinalizados |
| Capacidade de processamento | 50 sinistros/dia/equipe | 250+ sinistros/dia |
Para uma seguradora de médio porte que processa 200 sinistros por dia:
- Antes: 15 reguladores gastando 60% do tempo com digitação
- Depois: A mesma equipe processa 3x o volume, focada na análise
- Impacto: Tempo médio de resolução reduzido de 14 para 5 dias
- Economia: 400.000 $+ por ano em custos de pessoal
Para quem é
- Seguradoras que tratam sinistros de automóvel, residenciais ou de saúde
- Administradoras de sinistros que processam para várias seguradoras
- Empresas de regulação de sinistros que precisam fechar mais processos por dia
- Escritórios de advocacia que organizam autos e documentos de descoberta
- Operadoras de saúde que processam reembolsos médicos e autorizações prévias