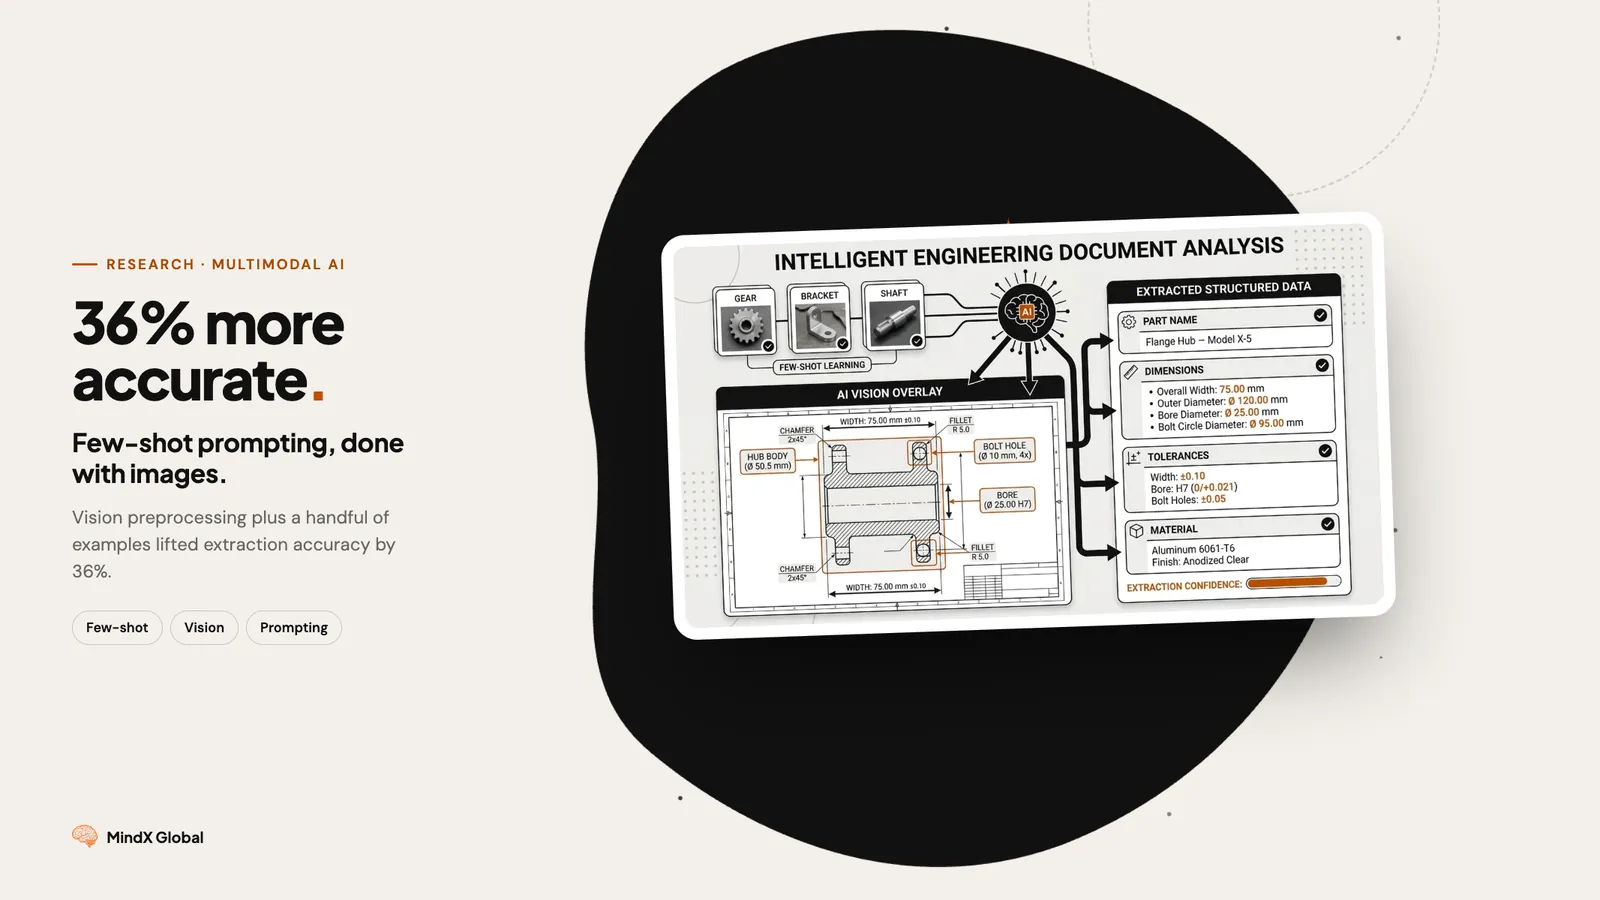
O Problema: Sua IA Não Consegue Ler Documentos Técnicos
Você já tentou GPT-4 Vision nos seus desenhos técnicos. Os resultados? Péssimos.
Abordagens padrão de IA falham em documentos especializados porque:
- Sem conhecimento de domínio: O modelo não entende layouts de quadros elétricos, estruturas de níveis ou convenções de componentes
- Sem âncoras visuais: Não consegue distinguir o que é importante do que é ruído
- Saídas inconsistentes: Cada resposta tem um formato diferente, quebrando seu processamento downstream
- Seções perdidas: Dados críticos são completamente ignorados
Nosso cliente enfrentou exatamente isso. Eles precisavam extrair números de nível, larguras, status de ventilação e valores de componentes de desenhos de quadros elétricos.
Primeira tentativa com zero-shot prompting: 18,2% de precisão.
Não é um erro de digitação. A IA acertou menos de 1 em 5 vezes.
E se você pudesse triplicar essa precisão sem mudar de modelo ou aumentar custos?
O Que Construímos: Pipeline Few-Shot + Visão Computacional
Combinamos duas técnicas que individualmente ajudam, mas juntas criam algo poderoso:
| Técnica | O Que Faz | Impacto |
|---|---|---|
| Pré-processamento CV | Destaca áreas-chave antes do LLM ver a imagem | Foca a atenção |
| Exemplos Few-Shot | Mostra ao modelo exatamente como é o sucesso | Ensina padrões |
| Saída Estruturada | Força schema JSON com Pydantic | Garante dados válidos |
Os Resultados
| Métrica | Zero-Shot | Few-Shot (4 Exemplos) | Melhoria |
|---|---|---|---|
| Taxa de Correspondência Exata | 18,2% | 54,5% | +36,3% |
| Precisão por Campo | 78,7% | 92,6% | +13,9% |
| Precisão de Contagem de Níveis | 72,7% | 100,0% | +27,3% |
A contagem de níveis foi de 72,7% para 100%. O modelo zero-shot fundamentalmente não entendia a estrutura do documento. Com exemplos, acertou todas as vezes.
Etapa 1: Pré-processamento de Visão Computacional
Antes do LLM ver seu documento, prepare-o visualmente.
Treinamos um modelo de detecção leve (Roboflow) para identificar componentes-chave:
- Placas MCMP: Sobreposição amarela + borda verde
- Unidades de medição: Contorno de borda azul
O LLM recebe uma imagem "guia". Em vez de escanear todo o desenho complexo, ele sabe exatamente onde focar.
Pense nisso como sublinhar um livro-texto antes de uma prova. O conteúdo é o mesmo, mas as partes importantes estão marcadas.
Etapa 2: Exemplos Few-Shot Que Realmente Funcionam
A diferença entre um bom e um ótimo few-shot prompting é a seleção de exemplos.
Exemplos Ruins
- Todos com complexidade similar
- Mesmo tipo de documento
- Sem casos extremos
Bons Exemplos (O Que Usamos)
- Exemplo 1: Layout simples, componentes mínimos
- Exemplo 2: Ventilação pesada, estrutura de níveis complexa
- Exemplo 3: Componentes mistos, larguras incomuns
- Exemplo 4: Caso extremo com dados faltantes
Insight chave: 4 exemplos diversos superam 20 similares. Qualidade e cobertura importam mais que quantidade.
Etapa 3: Forçar Estrutura com Pydantic
Mesmo com ótimos exemplos, LLMs podem produzir JSON malformado. Usamos Pydantic para garantir saídas válidas — sem mais erros de parsing JSON, sem campos faltantes, sem incompatibilidades de tipo.
O Que Você Pode Aplicar Hoje
- Não comece com o LLM. Use CV para pré-processar e destacar regiões-chave primeiro.
- Monte um conjunto diverso de exemplos. Cubra casos extremos, não apenas cenários felizes. 4-6 exemplos de alta qualidade superam 20 mediocres.
- Force estrutura. Use Pydantic, Zod ou JSON Schema. Nunca confie em saída livre de LLM em produção.
- Meça corretamente. Acompanhe taxa de correspondência exata E precisão por campo. Elas contam histórias diferentes.
| Caso de Uso | Melhoria Esperada |
|---|---|
| Desenhos técnicos | 30-40% de aumento na precisão |
| Formulários médicos | 20-35% de aumento na precisão |
| Documentos financeiros | 25-40% de aumento na precisão |
| Formulários manuscritos | 15-30% de aumento na precisão |
Resumo dos Resultados
| Antes | Depois | Impacto |
|---|---|---|
| 18,2% correspondência exata | 54,5% correspondência exata | Melhoria de 3x |
| JSON inconsistente | Schema garantido | Zero erros de parsing |
| Revisão manual necessária | Pipeline automatizado | Horas economizadas diariamente |
| Qualidade de protótipo | Pronto para produção | Implantado para o cliente |