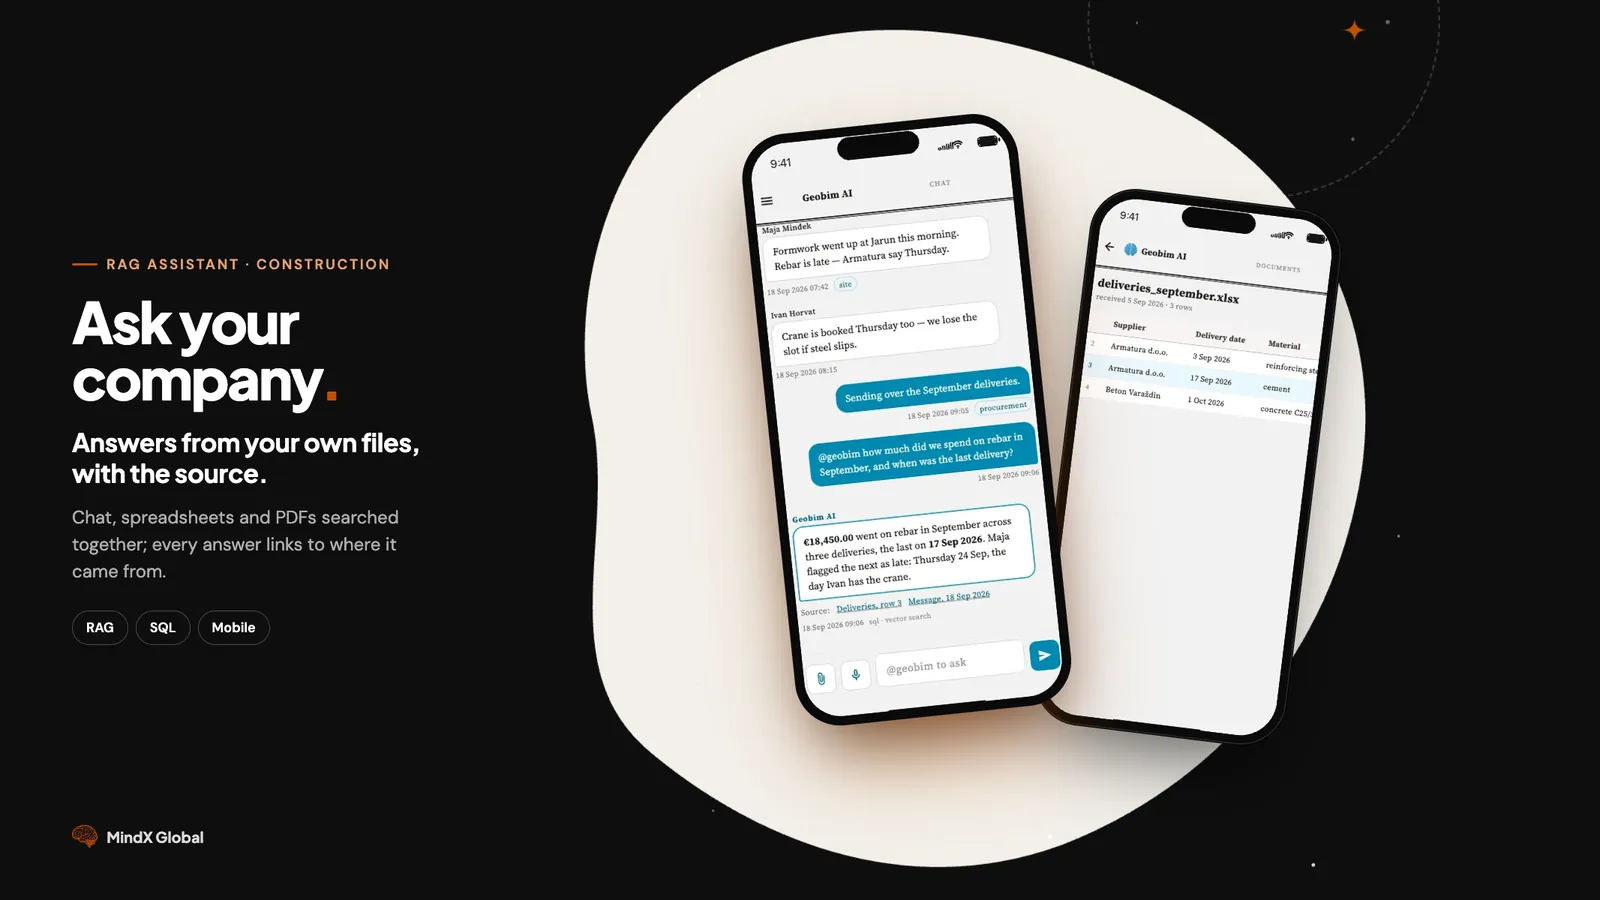
El problema: la respuesta existe, pero nadie la encuentra
Una empresa de construcción y topografía funciona a base de datos pequeños. Cuándo llega el acero corrugado. Qué decía el último levantamiento. Quién cotizó qué, y cuándo.
Esos datos existen. Solo que están dispersos:
- Notas de voz grabadas caminando por la obra
- Fotos de un plano anotado
- Hojas de cálculo enviadas por correo una vez y nunca reabiertas
- PDF de proveedores y del catastro
- Mensajes en un chat de grupo que para mediodía ya se ha ido hacia arriba
Pregunte «¿cuánto gastamos en acero en septiembre?» y la respuesta está en una hoja de cálculo. Pregunte «¿cuándo es la próxima entrega?» y está en una nota de voz del martes. Nadie tiene ambas cosas en la cabeza.
Así que se pregunta a un compañero. El compañero se pone a buscar. Ahora hay dos personas que no trabajan.
Por qué un buscador no lo resuelve
La búsqueda encuentra documentos, no respuestas. Escriba «acero septiembre» y obtendrá cinco hojas de cálculo. Seguirá teniendo que abrirlas y sumar usted mismo.
Y la mayoría de las herramientas de IA documental no saben calcular. El enfoque habitual es trocearlo todo en fragmentos, encontrar los que se parecen a la pregunta y pasárselos a un modelo de lenguaje. Funciona para «¿qué dice nuestra política de seguridad?». Se desmorona con «¿cuánto gastamos?».
Una búsqueda por similitud encuentra las filas. No sabe sumarlas. Y no puede decir qué fila usó, así que no hay forma de comprobarlo.
Para una empresa que firma contratos con esas cifras, una respuesta que no se puede comprobar no es una respuesta.
Qué construimos
Un asistente interno, en croata, que la plantilla usa como un chat de grupo.
Todo llega a un mismo sitio: mensajes escritos, notas de voz, hojas de cálculo, PDF, fotos. Después, cualquiera puede preguntarle al chat y recibir una respuesta con enlace a su origen.
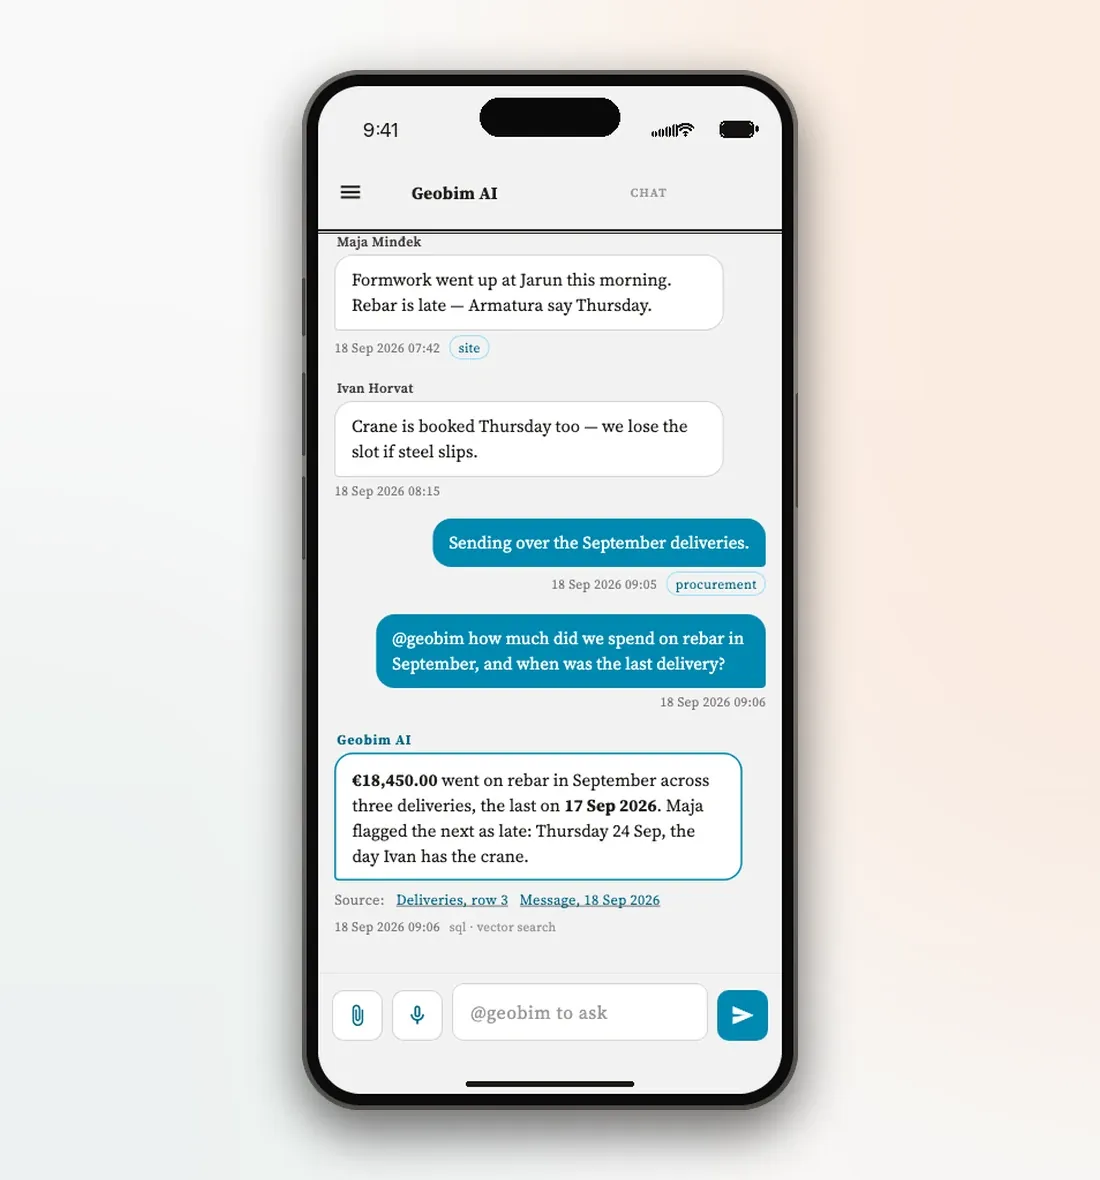
Con todo lo que entra ocurren dos cosas.
Primero, se guarda. En bruto y de inmediato, antes de intentar nada ingenioso. Nada se descarta porque un clasificador tuviera un mal día.
Segundo, un filtro decide si es información de negocio. «La entrega llega el jueves» lo es. «¿Quién quiere café?» no. Lo que pasa el filtro se procesa por duplicado:
- Como hechos en una tabla: proveedores, fechas, importes, materiales. Esto es lo que hace posible la aritmética.
- Como significado consultable: para que «acero» encuentre también «corrugado», y una pregunta mal formulada acierte igualmente.
Cuando alguien pregunta, el asistente usa ambas vías. Lanza una consulta real a la base de datos para lo numérico y una búsqueda por significado para lo descriptivo, y responde combinando las dos.
Cada respuesta enseña de dónde sale
Esto era lo que más le importaba al cliente.
Bajo cada respuesta hay enlaces a la fuente. No «según sus documentos», sino un enlace a la fila exacta de la hoja, la página del PDF o el mensaje del que sale la cifra. Se toca y se aterriza en esa fila, resaltada.
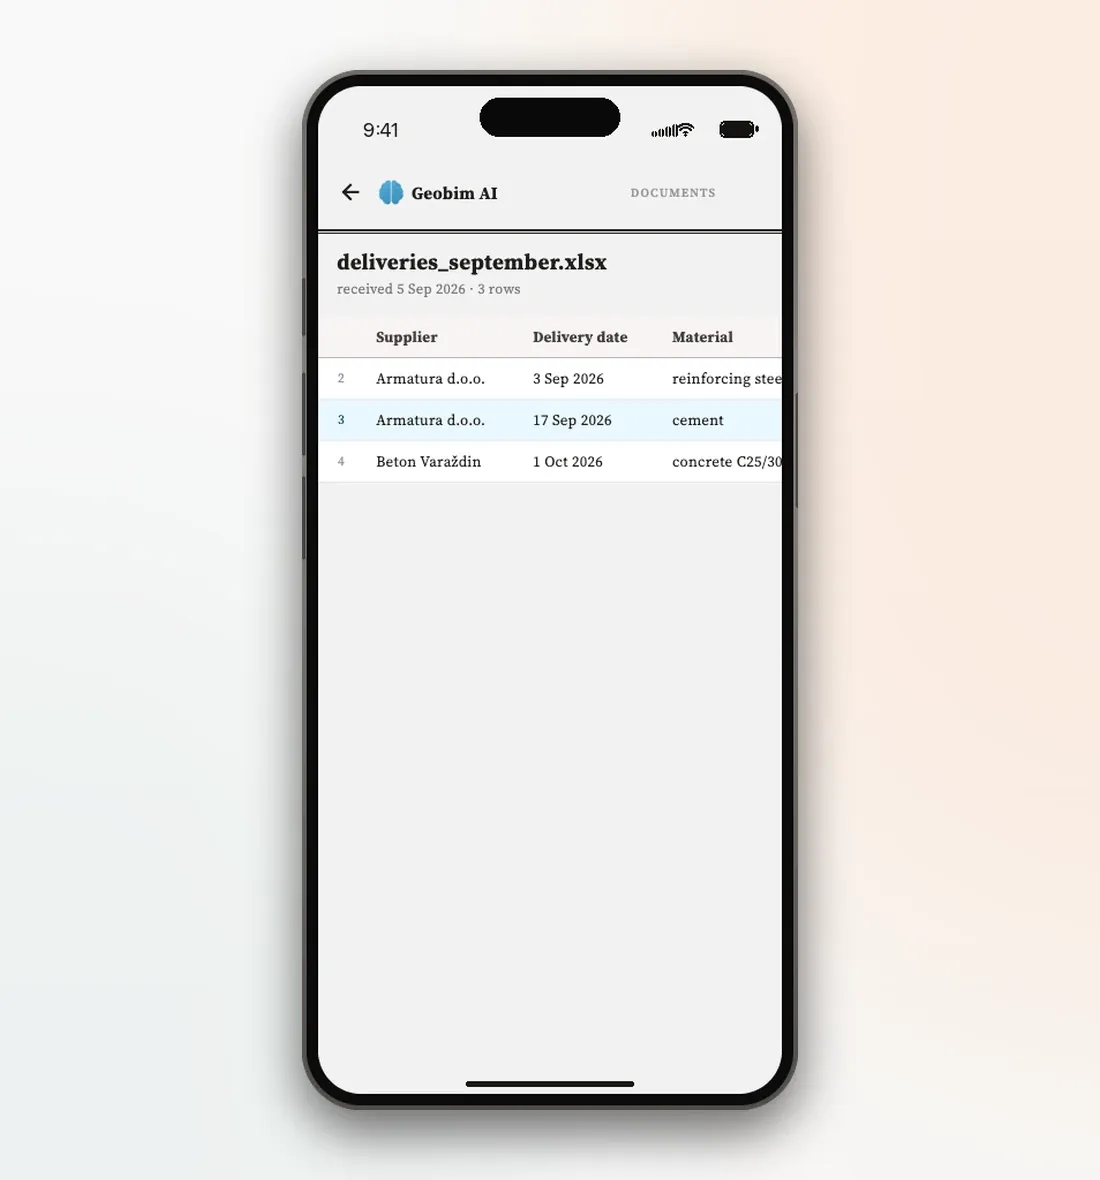
Eso cambia la relación con la herramienta. Una respuesta que se comprueba con un toque es una respuesta sobre la que se actúa.
Las fechas salen de la conversación
El trabajo de obra se planifica de pasada. «El levantamiento lo hacemos el jueves» se dice una vez, en una nota de voz, y no se escribe en ningún otro sitio.
El asistente lee esas menciones y las lleva a un calendario, con un enlace de vuelta a la frase de la que salieron.
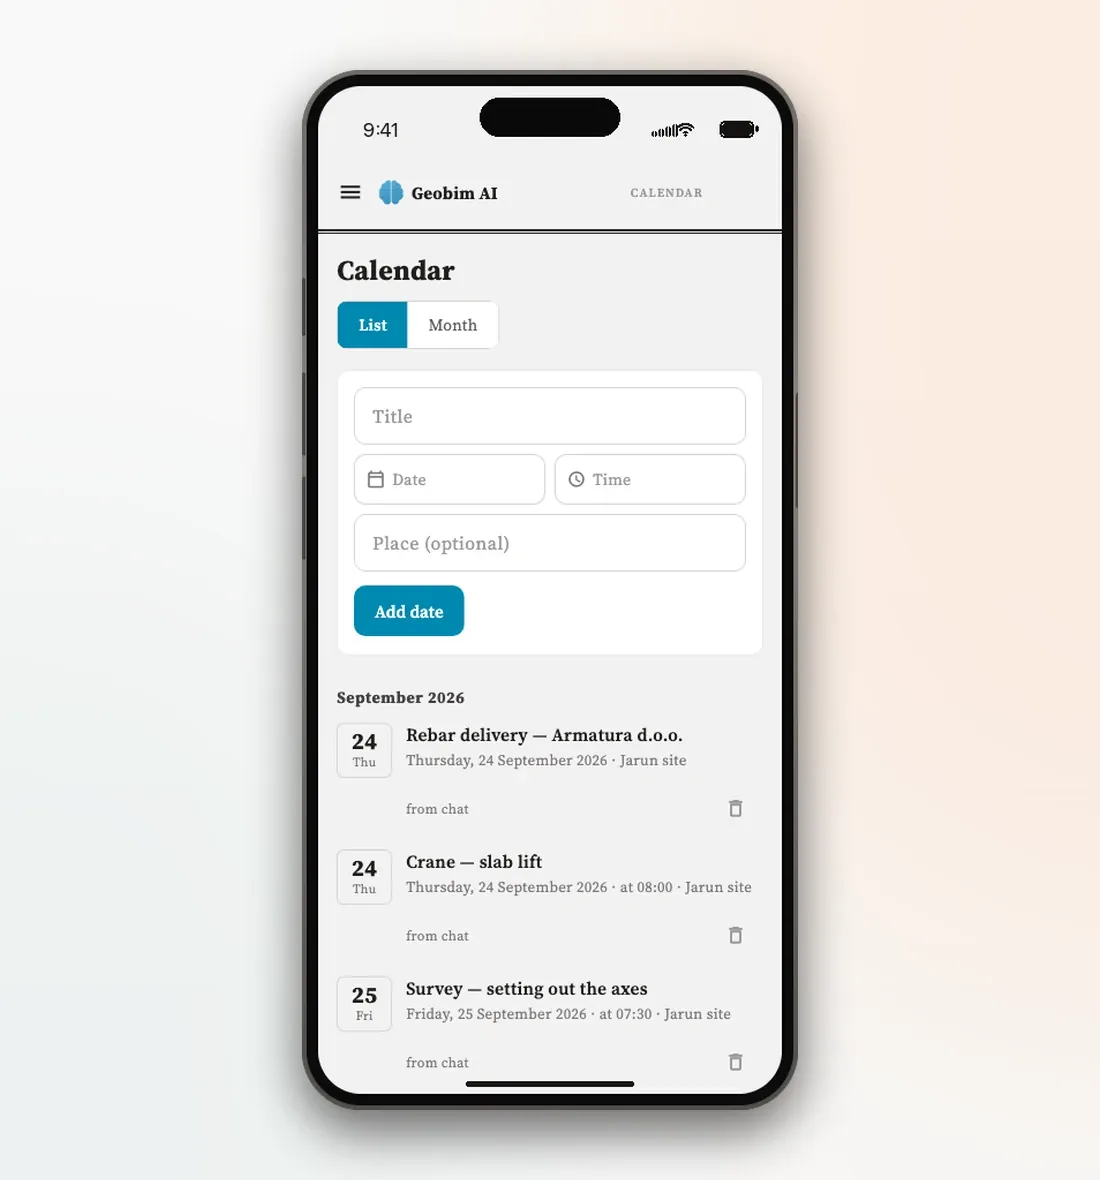
Un detalle importó más de lo que esperábamos. La gente se equivoca habitualmente en la mitad de una fecha: dirá «el domingo 18» cuando el 18 es viernes. En lugar de dejar que la IA elija en silencio y suene segura, la discrepancia se marca para que la revise una persona. Una fecha equivocada que se convierte calladamente en un compromiso es peor que no tener fecha.
Lo difícil
El croata está mal atendido por las herramientas estándar. La mayoría de los motores de búsqueda de texto traen soporte para inglés y una docena de idiomas más. El croata no está entre ellos. Tuvimos que construir el tratamiento lingüístico a mano, incluido un fallo por el que đ atraviesa sin cambios el paso estándar de normalización de texto, de modo que cualquier búsqueda de un nombre como Đuro fallaba en silencio. Ahora hay una prueba cuya única razón de existir es impedir que alguien «simplifique» eso.
El filtro promueve, nunca borra. Los mensajes y archivos originales se conservan siempre. El filtro solo decide qué sigue procesándose. Eso significa que, cuando lo mejoramos, podemos volver a pasarlo por todo lo ya recogido, algo imposible si la primera versión hubiera descartado cosas.
Es una app de móvil, porque el trabajo ocurre en la calle. El personal de obra no está en un escritorio. La app está pensada para usarse con una mano en la furgoneta o en el tajo: grabar una nota de voz, fotografiar un plano, hacer una pregunta.
Para qué sirve este patrón
Esto no es exclusivo de la construcción. La misma forma encaja en cualquier empresa donde el conocimiento es real pero está disperso, y donde una respuesta equivocada tiene consecuencias:
- Servicios profesionales: historial de proyectos, alcance del trabajo, quién acordó qué
- Industria: condiciones de proveedores, especificaciones de piezas, historial de incidencias
- Inmobiliario y mantenimiento: registros de mantenimiento, costes por emplazamiento, historial de contratistas
- Cualquier empresa que viva en un chat de grupo: donde la memoria de la organización está de verdad en el chat, y se va cuando se va la gente
Vale la pena repetir las dos cosas que hacen que funcione: combinar consultas reales a base de datos con búsqueda por significado y citar la fuente exacta. Sin lo primero, no sabe contar. Sin lo segundo, nadie se fía.