El Problema: Su IA No Puede Leer Documentos Técnicos
Ha probado GPT-4 Vision con sus dibujos técnicos. ¿Los resultados? Basura.
Los enfoques estándar de IA fallan en documentos especializados porque:
- Sin conocimiento del dominio: El modelo no entiende diseños de tableros eléctricos, estructuras de niveles o convenciones de componentes
- Sin anclas visuales: No puede distinguir lo importante del ruido
- Salidas inconsistentes: Cada respuesta tiene un formato diferente, rompiendo su procesamiento posterior
- Secciones omitidas: Datos críticos se pasan por alto por completo
Nuestro cliente enfrentó exactamente esto. Necesitaban extraer números de nivel, anchos, estado de ventilación y valores de componentes de dibujos de tableros eléctricos.
Primer intento con prompting zero-shot: 18.2% de precisión.
No es un error tipográfico. La IA acertó menos de 1 de cada 5 veces.
¿Y si pudiera triplicar esa precisión sin cambiar de modelo ni aumentar costos?
Lo Que Construimos: Pipeline Few-Shot + Visión por Computadora
Combinamos dos técnicas que individualmente ayudan, pero juntas crean algo poderoso:
| Técnica | Qué Hace | Impacto |
|---|---|---|
| Preprocesamiento CV | Resalta áreas clave antes de que el LLM vea la imagen | Enfoca la atención |
| Ejemplos Few-Shot | Muestra al modelo exactamente cómo es el éxito | Enseña patrones |
| Salida Estructurada | Aplica esquema JSON con Pydantic | Garantiza datos válidos |
Los Resultados
| Métrica | Zero-Shot | Few-Shot (4 Ejemplos) | Mejora |
|---|---|---|---|
| Tasa de Coincidencia Exacta | 18.2% | 54.5% | +36.3% |
| Precisión por Campo | 78.7% | 92.6% | +13.9% |
| Precisión de Conteo de Niveles | 72.7% | 100.0% | +27.3% |
El conteo de niveles pasó de 72.7% a 100%. El modelo zero-shot malinterpretó fundamentalmente la estructura del documento. Con ejemplos, acertó cada vez.
Paso 1: Preprocesamiento con Visión por Computadora
Antes de que el LLM vea su documento, prepárelo visualmente.
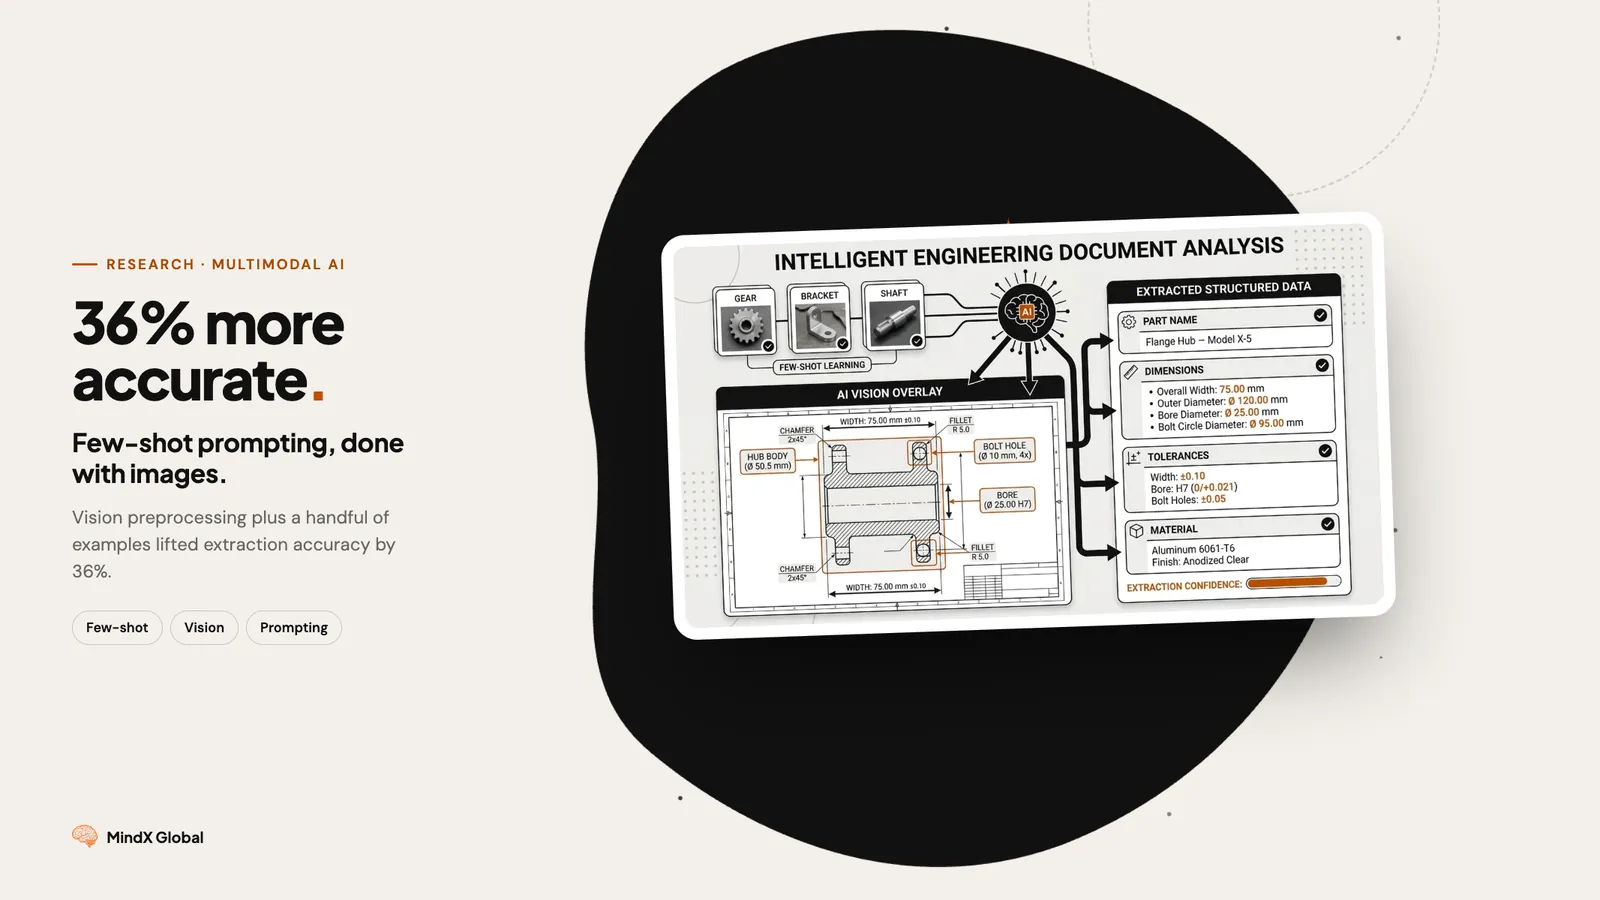
Entrenamos un modelo de detección ligero (Roboflow) para identificar componentes clave:
- Placas MCMP: Superposición amarilla + borde verde
- Unidades de medición: Contorno de borde azul
El LLM recibe una imagen de "hoja de trucos". En lugar de escanear todo el dibujo complejo, sabe exactamente dónde enfocarse.
Piense en ello como subrayar un libro de texto antes de un examen. El contenido es el mismo, pero las partes importantes están marcadas.
Paso 2: Ejemplos Few-Shot Que Realmente Funcionan
La diferencia entre un buen y un excelente prompting few-shot es la selección de ejemplos.
Malos Ejemplos
- Todos de complejidad similar
- Mismo tipo de documento
- Sin casos límite
Buenos Ejemplos (Lo Que Usamos)
- Ejemplo 1: Diseño simple, componentes mínimos
- Ejemplo 2: Ventilación pesada, estructura de niveles compleja
- Ejemplo 3: Componentes mixtos, anchos inusuales
- Ejemplo 4: Caso límite con datos faltantes
Información clave: 4 ejemplos diversos superan a 20 similares. La calidad y cobertura importan más que la cantidad.
Paso 3: Imponer Estructura con Pydantic
Incluso con excelentes ejemplos, los LLMs pueden generar JSON malformado. Usamos Pydantic para garantizar salidas válidas — sin más errores de parsing JSON, sin campos faltantes, sin errores de tipo.
Lo Que Puede Aplicar Hoy
- No empiece con el LLM. Use CV para preprocesar y resaltar regiones clave primero.
- Construya un conjunto de ejemplos diverso. Cubra casos límite, no solo caminos felices. 4-6 ejemplos de alta calidad superan a 20 mediocres.
- Imponga estructura. Use Pydantic, Zod o JSON Schema. Nunca confíe en salida de LLM en formato libre en producción.
- Mida correctamente. Rastree la tasa de coincidencia exacta Y la precisión por campo. Cuentan historias diferentes.
| Caso de Uso | Mejora Esperada |
|---|---|
| Dibujos técnicos | 30-40% más de precisión |
| Formularios médicos | 20-35% más de precisión |
| Documentos financieros | 25-40% más de precisión |
| Formularios manuscritos | 15-30% más de precisión |
Resumen de Resultados
| Antes | Después | Impacto |
|---|---|---|
| 18.2% coincidencia exacta | 54.5% coincidencia exacta | Mejora de 3x |
| JSON inconsistente | Esquema garantizado | Cero errores de parsing |
| Revisión manual requerida | Pipeline automatizado | Horas ahorradas diariamente |
| Calidad de prototipo | Listo para producción | Desplegado al cliente |