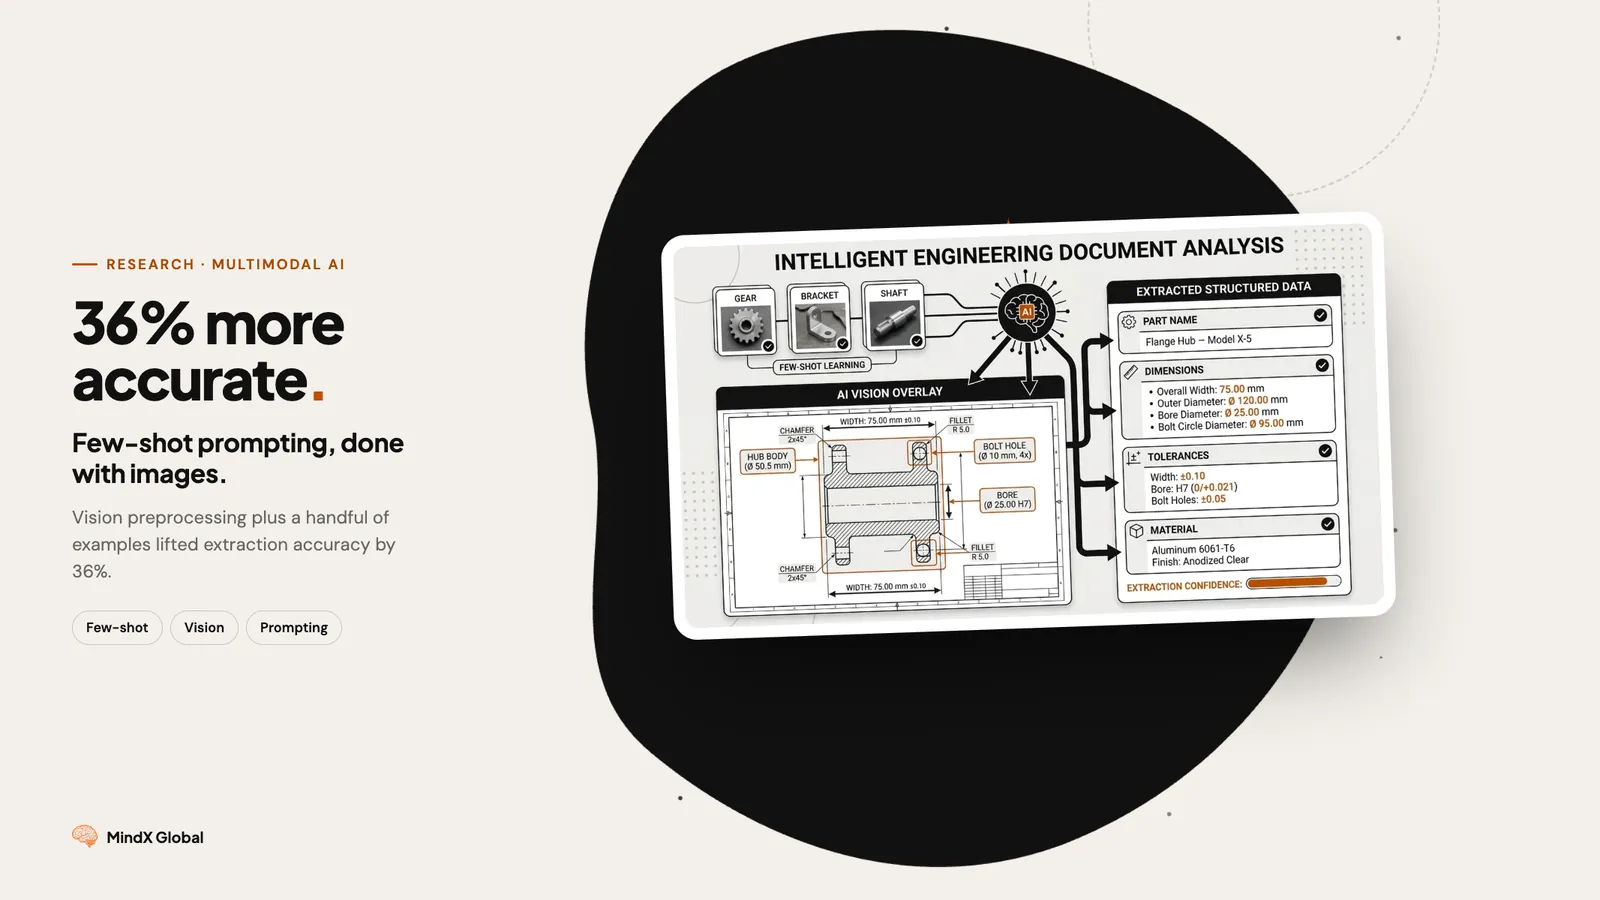
Il Problema: La Tua IA Non Riesce a Leggere Documenti Tecnici
Hai provato GPT-4 Vision sui tuoi disegni tecnici. I risultati? Inutilizzabili.
Gli approcci IA standard falliscono sui documenti specializzati perché:
- Nessuna conoscenza di dominio: Il modello non comprende layout di quadri elettrici, strutture a livelli o convenzioni dei componenti
- Nessun riferimento visivo: Non riesce a distinguere ciò che è importante dal rumore
- Output inconsistenti: Ogni risposta ha un formato diverso, compromettendo l'elaborazione a valle
- Sezioni mancanti: Dati critici vengono completamente ignorati
Il nostro cliente aveva esattamente questo problema. Doveva estrarre numeri dei livelli, larghezze, stato della ventilazione e valori dei componenti da disegni di quadri elettrici.
Primo tentativo con zero-shot prompting: 18,2% di precisione.
Non è un errore di battitura. L'IA indovinava correttamente meno di 1 volta su 5.
E se potessi triplicare quella precisione senza cambiare modello né aumentare i costi?
Cosa Abbiamo Costruito: Pipeline Few-Shot + Computer Vision
Abbiamo combinato due tecniche che individualmente aiutano, ma insieme creano qualcosa di potente:
| Tecnica | Cosa Fa | Impatto |
|---|---|---|
| Preprocessing CV | Evidenzia le aree chiave prima che il LLM veda l'immagine | Focalizza l'attenzione |
| Esempi Few-Shot | Mostra al modello esattamente com'è il successo | Insegna i pattern |
| Output Strutturato | Impone lo schema JSON con Pydantic | Garantisce dati validi |
I Risultati
| Metrica | Zero-Shot | Few-Shot (4 Esempi) | Miglioramento |
|---|---|---|---|
| Corrispondenza Esatta | 18,2% | 54,5% | +36,3% |
| Precisione per Campo | 78,7% | 92,6% | +13,9% |
| Precisione Conteggio Livelli | 72,7% | 100,0% | +27,3% |
Il conteggio dei livelli è passato dal 72,7% al 100%. Il modello zero-shot fraintendeva fondamentalmente la struttura del documento. Con gli esempi, ha indovinato correttamente ogni singola volta.
Fase 1: Preprocessing con Computer Vision
Prima che il LLM veda il tuo documento, preparalo visivamente.
Abbiamo addestrato un modello di rilevamento leggero (Roboflow) per identificare i componenti chiave:
- Piastre MCMP: Sovrapposizione gialla + bordo verde
- Unità di misurazione: Contorno bordo blu
Il LLM riceve un'immagine "riassuntiva". Invece di scansionare l'intero disegno complesso, sa esattamente dove concentrarsi.
Pensa come evidenziare un libro di testo prima di un esame. Il contenuto è lo stesso, ma le parti importanti sono segnate.
Fase 2: Esempi Few-Shot Che Funzionano Davvero
La differenza tra un buon few-shot prompting e uno eccellente è la selezione degli esempi.
Esempi Cattivi
- Tutti di complessità simile
- Stesso tipo di documento
- Nessun caso limite
Esempi Buoni (Quelli Che Abbiamo Usato)
- Esempio 1: Layout semplice, componenti minimi
- Esempio 2: Ventilazione pesante, struttura a livelli complessa
- Esempio 3: Componenti misti, larghezze insolite
- Esempio 4: Caso limite con dati mancanti
Insight chiave: 4 esempi diversificati battono 20 simili. Qualità e copertura contano più della quantità.
Fase 3: Imporre la Struttura con Pydantic
Anche con ottimi esempi, i LLM possono produrre JSON malformato. Usiamo Pydantic per garantire output validi — niente più errori di parsing JSON, niente campi mancanti, niente errori di tipo.
Cosa Puoi Applicare Oggi
- Non partire dal LLM. Usa la CV per preprocessare ed evidenziare le regioni chiave prima.
- Costruisci un set di esempi diversificato. Copri i casi limite, non solo i percorsi felici. 4-6 esempi di alta qualità battono 20 mediocri.
- Imponi la struttura. Usa Pydantic, Zod o JSON Schema. Non fidarti mai dell'output libero del LLM in produzione.
- Misura correttamente. Traccia il tasso di corrispondenza esatta E la precisione per campo. Raccontano storie diverse.
| Caso d'Uso | Miglioramento Atteso |
|---|---|
| Disegni tecnici | 30-40% aumento precisione |
| Moduli medici | 20-35% aumento precisione |
| Documenti finanziari | 25-40% aumento precisione |
| Moduli scritti a mano | 15-30% aumento precisione |
Riepilogo Risultati
| Prima | Dopo | Impatto |
|---|---|---|
| 18,2% corrispondenza esatta | 54,5% corrispondenza esatta | Miglioramento 3x |
| JSON inconsistente | Schema garantito | Zero errori di parsing |
| Revisione manuale necessaria | Pipeline automatizzata | Ore risparmiate al giorno |
| Qualità prototipo | Pronto per la produzione | Implementato per il cliente |